AWS Community Day - re:Invent 특집

일정
- 시작 일시: 2020년 1월 21일 13시 00분
- 종료 일시: 2020년 1월 21일 17시 30분
키노트
신규 출시 서비스 및 기능 알아보기
- AWS Graviton2 Processor
- 클라우드 기반 최초의 ARM 기반 프로세서
- AWS 설계한 16mm 실리콘으로 64비트 ARM Neoverse 코어에 구축
- 최대 16개의 vCPU, 10Gbps
- 최대 40% 향상된 가격 대비 성능 제공
- 인스턴스 타입
- M6g ( Preview )
- C6g, R6g ( 2020년 Comming Soon )
- AQUA ( Advanced Query Accelerator ) for Amazon Redshift
- 새로운 하드웨어 기반 가속 캐시를 통해 비용 증가 없이 타 클라우드 데이터 웨어하우스 보다 10배 빠르게 질의 실행
- Amazon Redshift Update
- RA3 Instance
- 기존 클라우드 기반 3배 성능 제공
- 비슷한 가격의 DS2 인스턴스로서 2배의 성능과 2배의 스토리지
- Amazon Athena Federated Query & PartiQL
- lambda 를 Connector 를 통해 다양한 데이터 베이스 솔루션과 연계하여 Query 할 수 있는 기능
- RDS, Aurora, S3 통합 SQL 질의 가능
- Apache Parquest 기반 S3 데이터 레이크 내보기를 통한 새로운 통찰력 제공
- PartiQL
- RDB 뿐만 아니라 다른 데이터 베이스에서도 쿼리를 할 수 있도록 만드는 표준 쿼리
- AWS Outposts
- AWS 인프라 및 주요 서비스, API 및 개발 도구를 고객 온-프레미스로 확장하는 완전 관리횽 서비스로서 기존 클라우드 애플리케이션을 낮은 대기 시간과 일관된 배포 제공
- AWS 리전 데이터 센터와 동일한 설계 인프라르 고객 시설에 제공
- AWS 리전 내부와 마찬가지로 AWS 에서 전체 관리, 모니터링 및 운영
- 동일한 API 및 도구를 제공하는 클라우드 단일 운영
- 온-프레미스 및 클라우드 환경에서 하이브리도 사용 가능
- 서울 리전에 출시
- AWS Wavelength
- 5G 네트워크 엣지에서 AWS 컴퓨팅 및 스토리지를 사용하여, 5G 기반 모바일 디바이스 및 사용자에게 한 자리 밀리 초 지연 시간을 제공하는 애플리케이션 제공 가능
- AWS Outposts 기반
- AWS 리전과 통신사 5G 망과 직접 연결
- 특징
- 5G 단말기 사용자를 위한 광대역 콘텐츠 서비스 제공
- 통신사 5G 망 관리 데이터 센터
- AWS 리전에서 직접 애플리케이션 배포 및 관리
- AWS Kendra
- 기업 내부 문서 및 데이터에 대한 기계 학습 기반 분석 기반 엔터프라이즈 검색 서비스
- 다양한 데이터 소스 ( S3, Sharepoint, 파일, 서버, HTTP 등 )
- 간단한 API 및 콘솔 코드 샘플 제공
- 아직 한국어는 지원하지 않음
- Amazon Braket
- 과학자와 개발자가 양자 컴퓨팅을 쉽게 탐색하고 실험 할 수 있는 완전 관리형 서비스
- 양자 알고리즘을 설계, 테스트 및 실행하기 위한 단일 환경
- 클라우드 기반 양자컴퓨팅 개발 환경
- AWS DeepComposer
- 세계 최초 기계 학습 기반 음악 연주 서비스로서 건반과 장르별 반주 생성을 통해 원하는 장르의 음악 작곡 서비스
- GEN 학습법을 가지고 반주를 만들어주는 서비스
- AWS DeepRacer Evo & New Challenge
- 클라우드 기반 3D 레이싱 시뮬레이터, 강화 학습으로 움직이는 1/18 비율의 완전 자율 경주용 자동차 및 글로벌 레이싱 리그르 통해 기계 학습 경험 제공
- AWS SageMaker Studio
- 기계 학습 모델 개발 및 배포를 위한 최초의 완전 통합 개발 환경 ( IDE )
- 손쉬운 기계 학습 모델 생성, 훈련 및 서비스 배포 완전 관리 서비스
- 특징
- 자동 ML 모델 생성
- 고품질 ML 모델 구성
- 기능
- Notebook
- Expreiment
- Processing
- Debugger
- Model Monitor
- Auto Pilot
- AWS Fargate for Amazon EKS
- 서버리스 Kube 컨테이너를 안전하고 안정적으로 대규모로 실행할 수 있는 방법
- 특징
- 단순화된 배포, 관리 및 확장 기능
- 모든 포드에 대한 강력한 보안 격리
- 응용 프로그램 구축에 집중 가능한 서버리스
- Fargate Spot
- ECS Capacity Providers
- ECS CLI 2.0
- Cluster AutoScaling
- Amazon CodeGuru
- 소스 코드 리뷰 및 높은 비용이나 오류를 유발하는 코드 수정 또는 개선을 자동으로 해주는 개발팀을 위한 인공 지능 서비스
- 특징
- Reviewer
- 비용 기반 판별
- Profiler
- 자바 언어 지원
- 비지니스에 영향을 주는 AI 서비스
- Amazon Personalize
- 높은 정확성의 시계열 예측 서비스 ( Amazon.com 에서 사용된것과 동일한 기술을 기반 )
- Amazon Fraud Detector
- 온라인 결제 사기 및 가짜 계정 생성과 같은 사기성 활동을 쉽게 식별할 수 있는 완전 관리형 AI 서비스
- Contact Lens for Amazon Connect
- 고객 대화에 대한 음성 인식, 자연어 처리를 통한 감정과 추세를 이해하는 Amazon Connect 용 ML 분석 기능
- 아직 한국에 출시 되지 않음
- Amazon Personalize
- 서버리스 애플리케이션 개발 플랫폼 지원
- Tool
- IDE
- AWS Toolkit for (PyCharm, IntelliJ, VS Code)
- AWS Amplify
- Serverless
- FireCracker
- IDE
- Service
- Provisioned Concurrency for AWS Lambda
- Cold Start 문제 해소
- HTTP APIs for Amazon API Gateway
- Amazon RDS Proxy
- Lambda 함수용 Connection Pool 및 Fail Over 기능 제공을 통한 애플리케이션 가용성 증가
- Provisioned Concurrency for AWS Lambda
- Tool
Heroes 패널 토크 - 클라우드 기술의 미래
- AWS 도입 했을 때 무엇이 바뀌는가?
- 앞으로 IDC 사업자, Cloud Vendor 만 남게 될것이고, 개인이 직접 구축하는 일은 거의 사라질것이다.
- AWS 가 복잡해지는 만큼 다양한 방법론과 활용도가 나오고 있고, 더 많은 레이어를 씌워서 간단하게 할 수 있는 방법을 고민하고 있다.
- AWS 가 처음 출시하고 난 이후 가장 크게 변화된 것?
- 애플리케이션이 복잡해지고, 비지니스 로직이 복잡해짐에 따라 서비스가 정말 많아졌다.
- 기존 AWS 는 좀 더 원천적인 기술에 대한 지원을 했었다면, 최근에는 좀 더 애플리케이션 레이어를 신경을 많이 쓰는거같다.
- 인프라 → Dev/Ops → 애플리케이션을 대체하는 느낌
- 기존에 AWS 를 접근하는 위주가 인프라를 담당하시는 위주였었다면, 최근 들어서는 개발자들이 좀 더 많은 접근이 있다
- 변화가 많은것은 정말 좋으나, 따라가기 힘들다
- 최근에 어떤 변화를 주시하고 있는가?
- 하이브리드 인프라 ( Outposts, Wavelength, Local Zone, AWS VMWare for Cloud ) 가 향후 많은 서비스들을 활용할 수 있는 기능이 될거라 생각
- 대한민국 IT 업계는 퍼포먼스에 대한 화두를 던진다
- re:Invent 에서 어떤걸 느꼈나?
- 기술 변화에 적응을 좀 더 빨리 할 필요가 있다
- AWS 성장과 함께 전세계 Cloud 변화 트렌드를 읽을 수 있는 기회가 되었다
- EKS on Fargate
- 이 서비스가 나오는것은 당연한 일이고, 예상 가능한 일이였다
- 여기서 가장 중요한것은
Saving Plan이 같이 따라온점이다
- Latency 에 대해 고민중인 파트너들이 많다
- AWS 를 도입 해야하는 이유를 설명한다면?
- 적은 인원으로 빠르게 서비스를 개발하고 싶다면 도입해야 한다
- 전세계에서 클라우드의 사용량은 10% 에 불과하다.
- 아직 늦지 않았고, 앞으로 더 발전하게 될 것이다
- 온-프레미스인가 클라우드인가 에 대한 질문은 이미 답이 나와있다
- 온-프레미스 이든 클라우드 이든 기술은 비슷하고, 비용에 대한 증가폭은 다 다르게 된다
- 클라우드 사용할것인가? 에 대해 고민하는것보다도 어떻게 더 잘 사용할것인가를 고민하는게 좋다
- 전세계 가장 큰 4개의 클라우드 업체는 더욱 더 성장할것이다
- 이미 선택은 와있고, 선택을 단순 1차원적인게 아니라 다각적인 측면에서 고려해봐야 한다
- 사람이 먼저다
세션
쿠알못이 Amazon EKS 로 안정적인 서비스 운영하기 ( 최용호, 넥슨코리아 )
내용
Master Node
- 컴포넌트들은 서로 통신하는게 없어서 컴포넌트가 장애가 발생하더라도 복원되면 문제가 없음
- 하지만 API 서버는 모든 컴포넌트들과 통신하고 있기 때문에 API 서버에 장애가 발생하면 모든 클러스터에 장애가 발생함
- 그래서 API 서버는 고가용성을 유지해야함
- etcd 도 장애가 발생 시 모든 클러스터에 장애가 발생함
- etcd 는 최소 3대를 유지해야 함
- 장애 발생 시 마스터 노드를 선택하는 투표를 하는데, 이를 위해 3대를 함
- Amazon EKS 가
Master Node를 다 관리 해줌 ( 접속 조차 할 필요가 없음 )
Woker Node
- Kubelet 이 설치되어 있고, cAdvisor 등 을 사용함
- Node / Container 지표 수집
- Scheduler 는 Worker Node 의 상태를 확인하고 Node 에 Pod 를 할당함
Amazon EKS Node Groups라는 기능이 추가되면서 Auto Scaling, 장애 복구 등을 다 관리해줌- EC2 는 사용자 계정에 생성됨
AWS EKS
설치 방법
-
AWS Management Console
-
AWS CLI
-
eksctl
- 제일 간단하고 쉽게 EKS 클러스터를 생성할 수 있음
$ eksctl create cluster \--name eks-test \--region ap-northeast-2 \--version 1.14 \--managed \--asg-access -
Terraform
- 인프라를 코드로 관리할 수 있음
인증 & 권한
- EKS 를 생성한 AWS IAM User 가 Master 권한을 흭득함
Kubernetes Admin→ kubectl 명령 ( API 호출 ) →Kube Master Node→AWS IAM- Kubectl 명령
- Master Node 는 IAM 에 유저 체크
- Kube RBAC 인증
- Kube RBAC
- Role ( NameSpace 단위 )
- Cluster Role ( Cluster 전역의 권한 할당 )
- AWS IAM 과 유사함
Role 생성( Kube 리소스에 대한 사용 권한 설정, Policy 설정 ) →Role Binding 생성( 대상 Role 의 권한 부여 )- EKS 클러스터를 관리할 관리자가 추가되었다면?
- mapUsers 에 IAM User 추가 및 권한 부여
- IAM Role 기반 인증 방법
- IAM Role 생성
- aws-auth ConfigMap 에 추가
- Cluster Role 또는 Role 생성
- Role Binding 또는 Cluster Role Binding 생성
- AWS-Auth 쪽에 Kube RBAC 설정
- 대상 사용자의 kubeconfig 파일에 인증 정보 설정
네트워크
eth0 (10.0.0.2) ↔docker0 (172.17.0.1)↔veth0 (172.17.0.2),veth0 (172.0.0.3)eth0 (10.0.0.2) ↔docker0 (172.17.0.2)↔veth0 (172.17.0.2),veth0 (172.0.0.4)- Overlay Network ( AWS CNI 사용 )
- 실제 VPC에 있는 IP 를 할당 받음
- VPC 에 IP Range 를 작게 잡으면 Pod 생성을 실패할 수 있음
- IP Range 에 여유가 있더라도 ENI 의 제약을 받아 Pod 생성을 실패할 수 있음
- Worker Node
- DaemonSet ( IPAM )
- IPAM 이 할당할 수 있는 아이피 대역이 제한됨
- IPAM 이 할당할 수 있는 최대를 초과할 경우 ENI 가 추가됨
- 인스턴스 유형에 따라서 ENI 개수가 제한되어 있고, ENI 에 따라서 할당할 수 있는 IP 개수의 제한이 있음
- Pod 최대 할당 개수 = 인스턴스 유형에 따른 ENI 수 * (ENI 별 IP 수 - 1)
- DaemonSet ( IPAM )
Volume
- 안정적인 저장소 준비 → 컨테이너에 안정적인 저장소를 마운트
- EBS, EFS 사용 가능
- Worker Node 에 있는 File System 을 사용할 수 있음
- 연동 방법
StorageClass생성volumeBindMode: WaitForFirstCosumer최초로 컨테이너에 마운트 되는 시점에 EBS 가 생성됨
PersistentVolumeClaim설정- 컨테이너 마운트
모니터링
- Master Node 의 컴포넌트 들의 로그들은 CloudWatch를 통해 확인할 수 있음 ( BlackBox )
- EKS 클러스터 설정에서 로깅 부분에 보고싶은 로그들을 활성화 해야함
- Pod 모니터링은 Container Insight 를 사용하면 간단하게 사용 가능
- 프로메테우스로 사용할 수 있지만, Container Insight 도 대체가 가능함
- CloudWatchAgentServerPolicy 설정이 필요함
- Node, Pod 에 대한 모니터링이 가능함
- 상세한 로그들도 확인이 가능함
결론
- 힘들고 어려운 부분들은 대부분 Amazon EKS 가 관리해줌
AWS Fargate on EKS 실전 사용하기 ( 용찬호, 데브시스터즈 )
내용
Fargate On EKS
- Fargate (ECS)
- 완전 관리형 컨테이너 서비스
- 범용 목적의 서버리스 컨테이너
- EKS
- 관리형 쿠버네티스 서비스
- EC2 노드 그룹을 Worker 로 사용
- EKS + Fargate
- Fargate 에 EKS 의 App 배포 가능
- 오케스트레이터: Kubernetes
- Control Plane + Data Plane 의 완전한 Serverless
- 관리해야 할 EC2 Instance 가 존재하지 않음
- 완전한 서버리스형 쿠버네티스 서비스
- coreDNS, add-on 등을 모두 Fargate 에 Deploy 가능
- 기존 Node Group 과 함께 WorkLoad 운영 가능 ( 하이브리드 운영 가능 )
장점
- 관리의 복잡도가 줄어든다
- Cluster AutoScaler 를 사용할 필요가 없음
- 비용 청구의 단위가 Pod 의 실행 시간이 된다
- Pod 를 사용해도 VM 수준의 격리가 가능
- Fargate 의 내부 구조에 의함
- 기존 애플리케이션의 변경 없이 Fargate 로 이전 가능
단점
- Resource 상한선 존재 ( 최대 4vCPU, 30GB 메모리 )
- Stateful한 workload 사용 불가능
- Daemonset 을 비롯한 Privileged Pod 사용 불가능
- NLB / ELB 사용 불가능
- ELB + Ingree 조합을 사용할 수 있음
Use Case
- Stateless 하고 리소스를 크게 요구하지 않으며 특별한 권한이 필요 없는 workload 에 적합함
- Hybrid 로 구성
- Fargate On EKS 에는 Stateless 한 서버
- EC2 에는 Stateful 한 서버
사용 방법
- 현재 버지니아, 오하이오, 아일랜드, 도쿄에서 지원
- EKS 클러스터 1.14 이상
- Fargate Profile 생성 ( Fargate 에 Pod 를 생성하는 조건을 명시 )
- 생성하는데 30초 ~ 1분 정도 걸림
Fargate On EKS 사용해보기 ( Demo 영상 )
- EC2 Node Group 으로 띄우는것보다 훨씬 빠르게 스케일링이 가능함
Fargate On EKS 내부 구조 Deep Dive
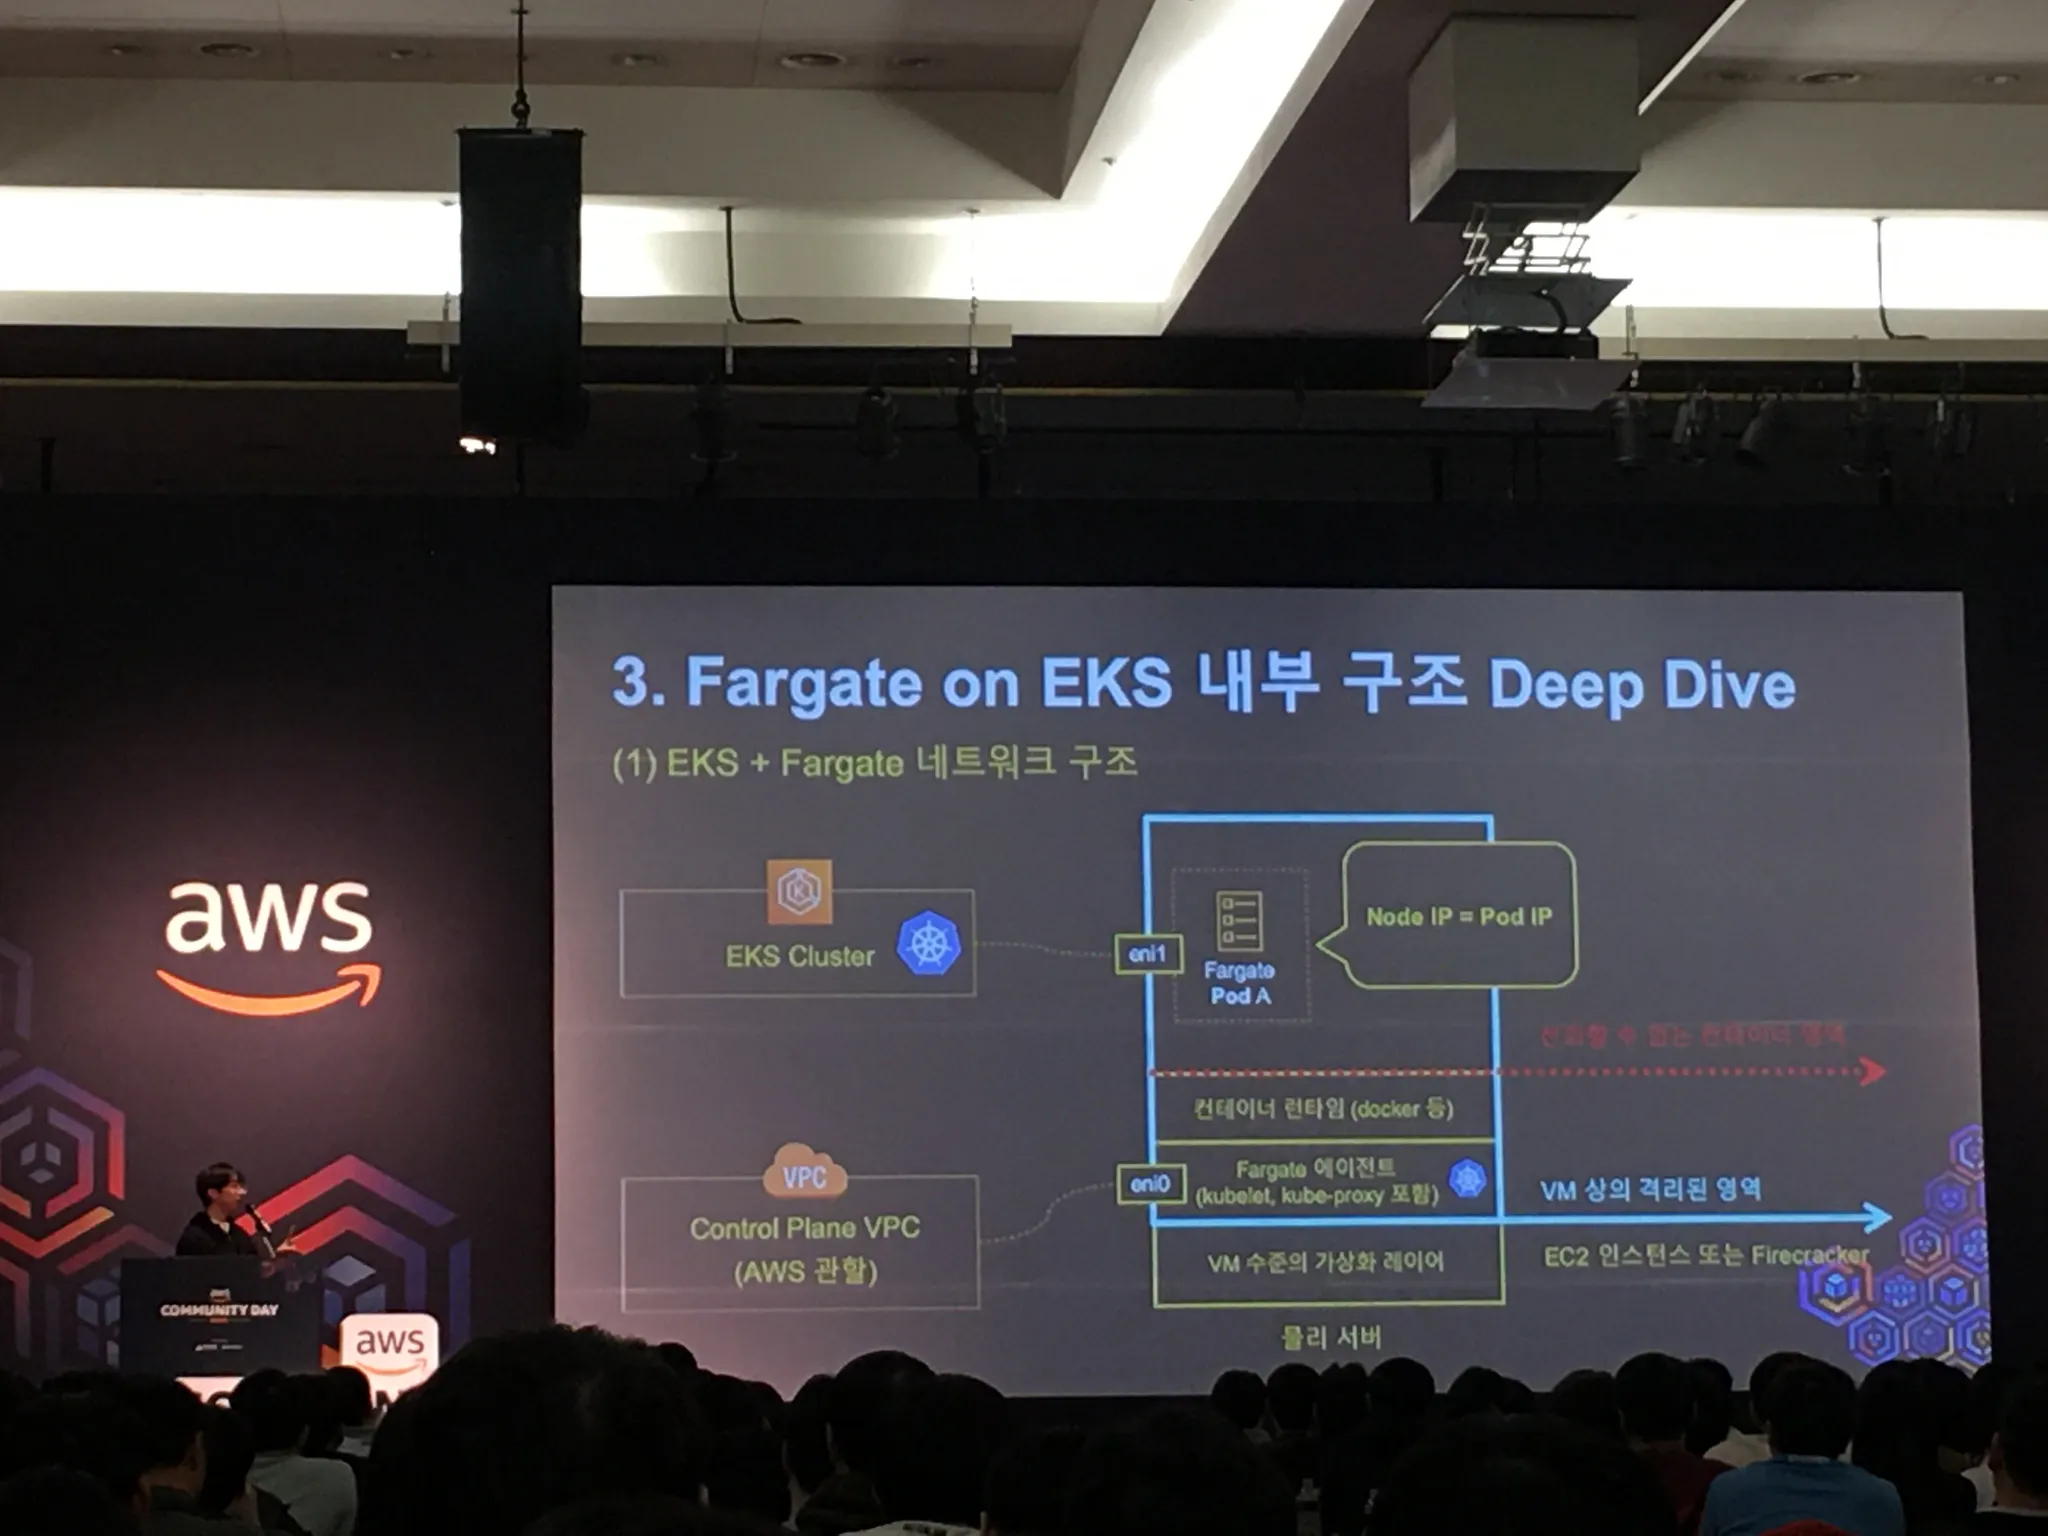
네트워크 구조
-
물리 서버 ↔ VM 수준의 가상화 레이어 ↔ Fargate 에이전트 ↔ 컨테이너 런타임 ( docker 등 )
- Fargate 는 1개의 컨테이너에 2개 이상의 Task 를 올리는것을 허용하지 않음
-
1개의 Pod = 1개의 Node
- IP 절약 측면에서 이점
- VM 수준의 격리 가능
-
Maximum Node: 5,000개
- Kube 는 최대 5천개의 Pod 만 사용 가능
스케줄링
- 스케줄링 순서
- Pod 생성 요청
- Admission Controller for Fargate
- 변경된 Pod Spec
- Fargate Scheduler
- Fargate Pod 할당
- 보이지 않는 AWS Admission Controller 가 Pod Spec 을 변경
- Pod Spec 에 compute-type 주석과 Fargate Profile 을 함께 사용할 경우
- compute-type 주석의 우선순위가 더 높음 ( 강제로 EC2 에 생성 )
요금 체계
- Resource + 256MB ( 쿠버네티스 컴포넌트 )
- 과금 되는 리소스 타입 0.5vCPU / 1GB
- EC2 인스턴스보다 좀 더 Find-Grained 한 리소스 사용 가능
- Burst 시나리오에서의 동작 유의 필요
- Best Effort, Bustable QoS 클래스의 Pod 의 경우, Limit 이 의미가 없음
- 요금 체계는
Request를 기준으로 함
- 무조건 Fargate On EKS 가 저렴하지 않을 수 있음
- Fargate On EKS 를 위한 Spot Instance, Saving Plan 지원 예정
결론
- Fargate On EKS 는 stateless 한 workload 를 수행하기에 적합
- EKS 에서 Fargate + EC2 를 혼합해 사용 가능
- stateless + stateful 의 혼합형 workload 구성 가능
- 여러분의 용도에 맞게, 좀 더 저렴한 방법을 선택
AWS 기반 서버리스 데이터레이크 구축하기 ( 김진웅, SK C&C )
내용
데이터 플라이휠
- Virtuous Cycle ( 선순환 )
- User → Data → Smarter Algorithms → Better Product → User ...
데이터 분석의 딜레마
- 데이터로 하고 싶은 일
- 마케팅 / 광고 최적화, 개인화
- 고객 이탈 방지
- 원인 분석
- 매출 증대
- 성과 측정
- 트렌드 파악 / 예측
- 쉽고 편한 분석
- 이미 겪고 있거나 예상되는 문제들
- 데이터 한군데 저장 어려움
- 다양한 데이터 포맷 정제 필요
- 일단 실험에 드는 부담
- 레거시 vs 신규 시스템
- 기술 내재화 어려움
- 채용 어려움 ( 인력 확보가 어려움 )
- 시간도 돈도 없음
- 법과 규제에 따른 데이터 활용 제약 ( 공유, 식별 )
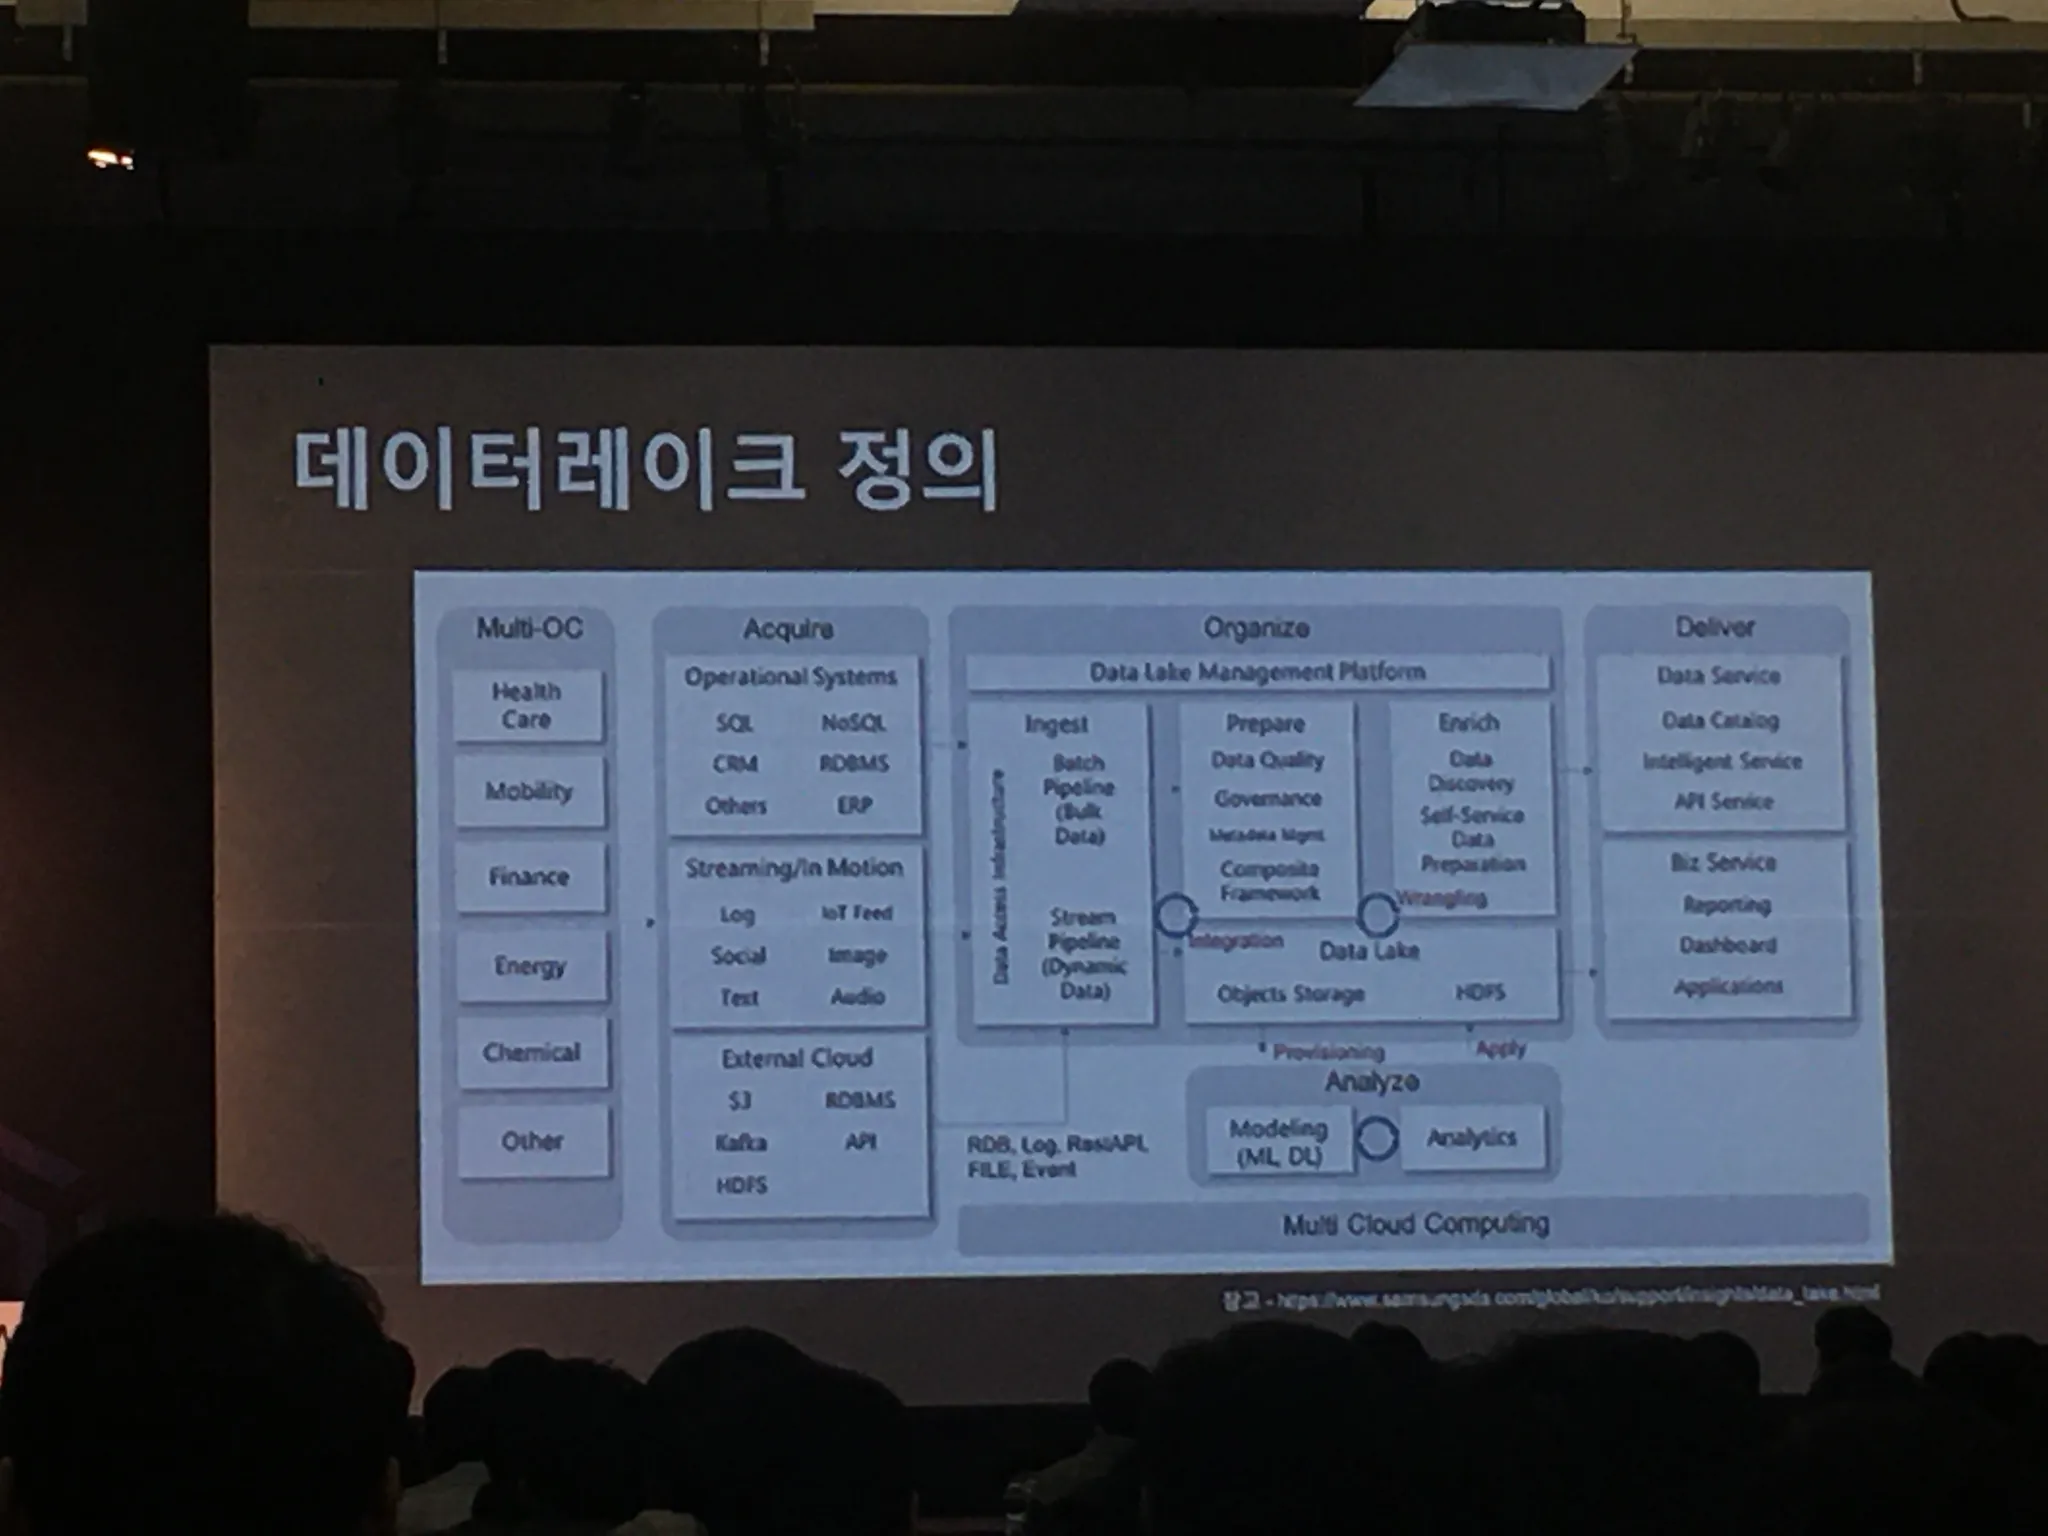
데이터 레이크 정의
-
AWS 가 정의한 데이터 레이크 : 정형화 또는 비정형화 된 모든 데이터를 중앙 집중화 시킨 것
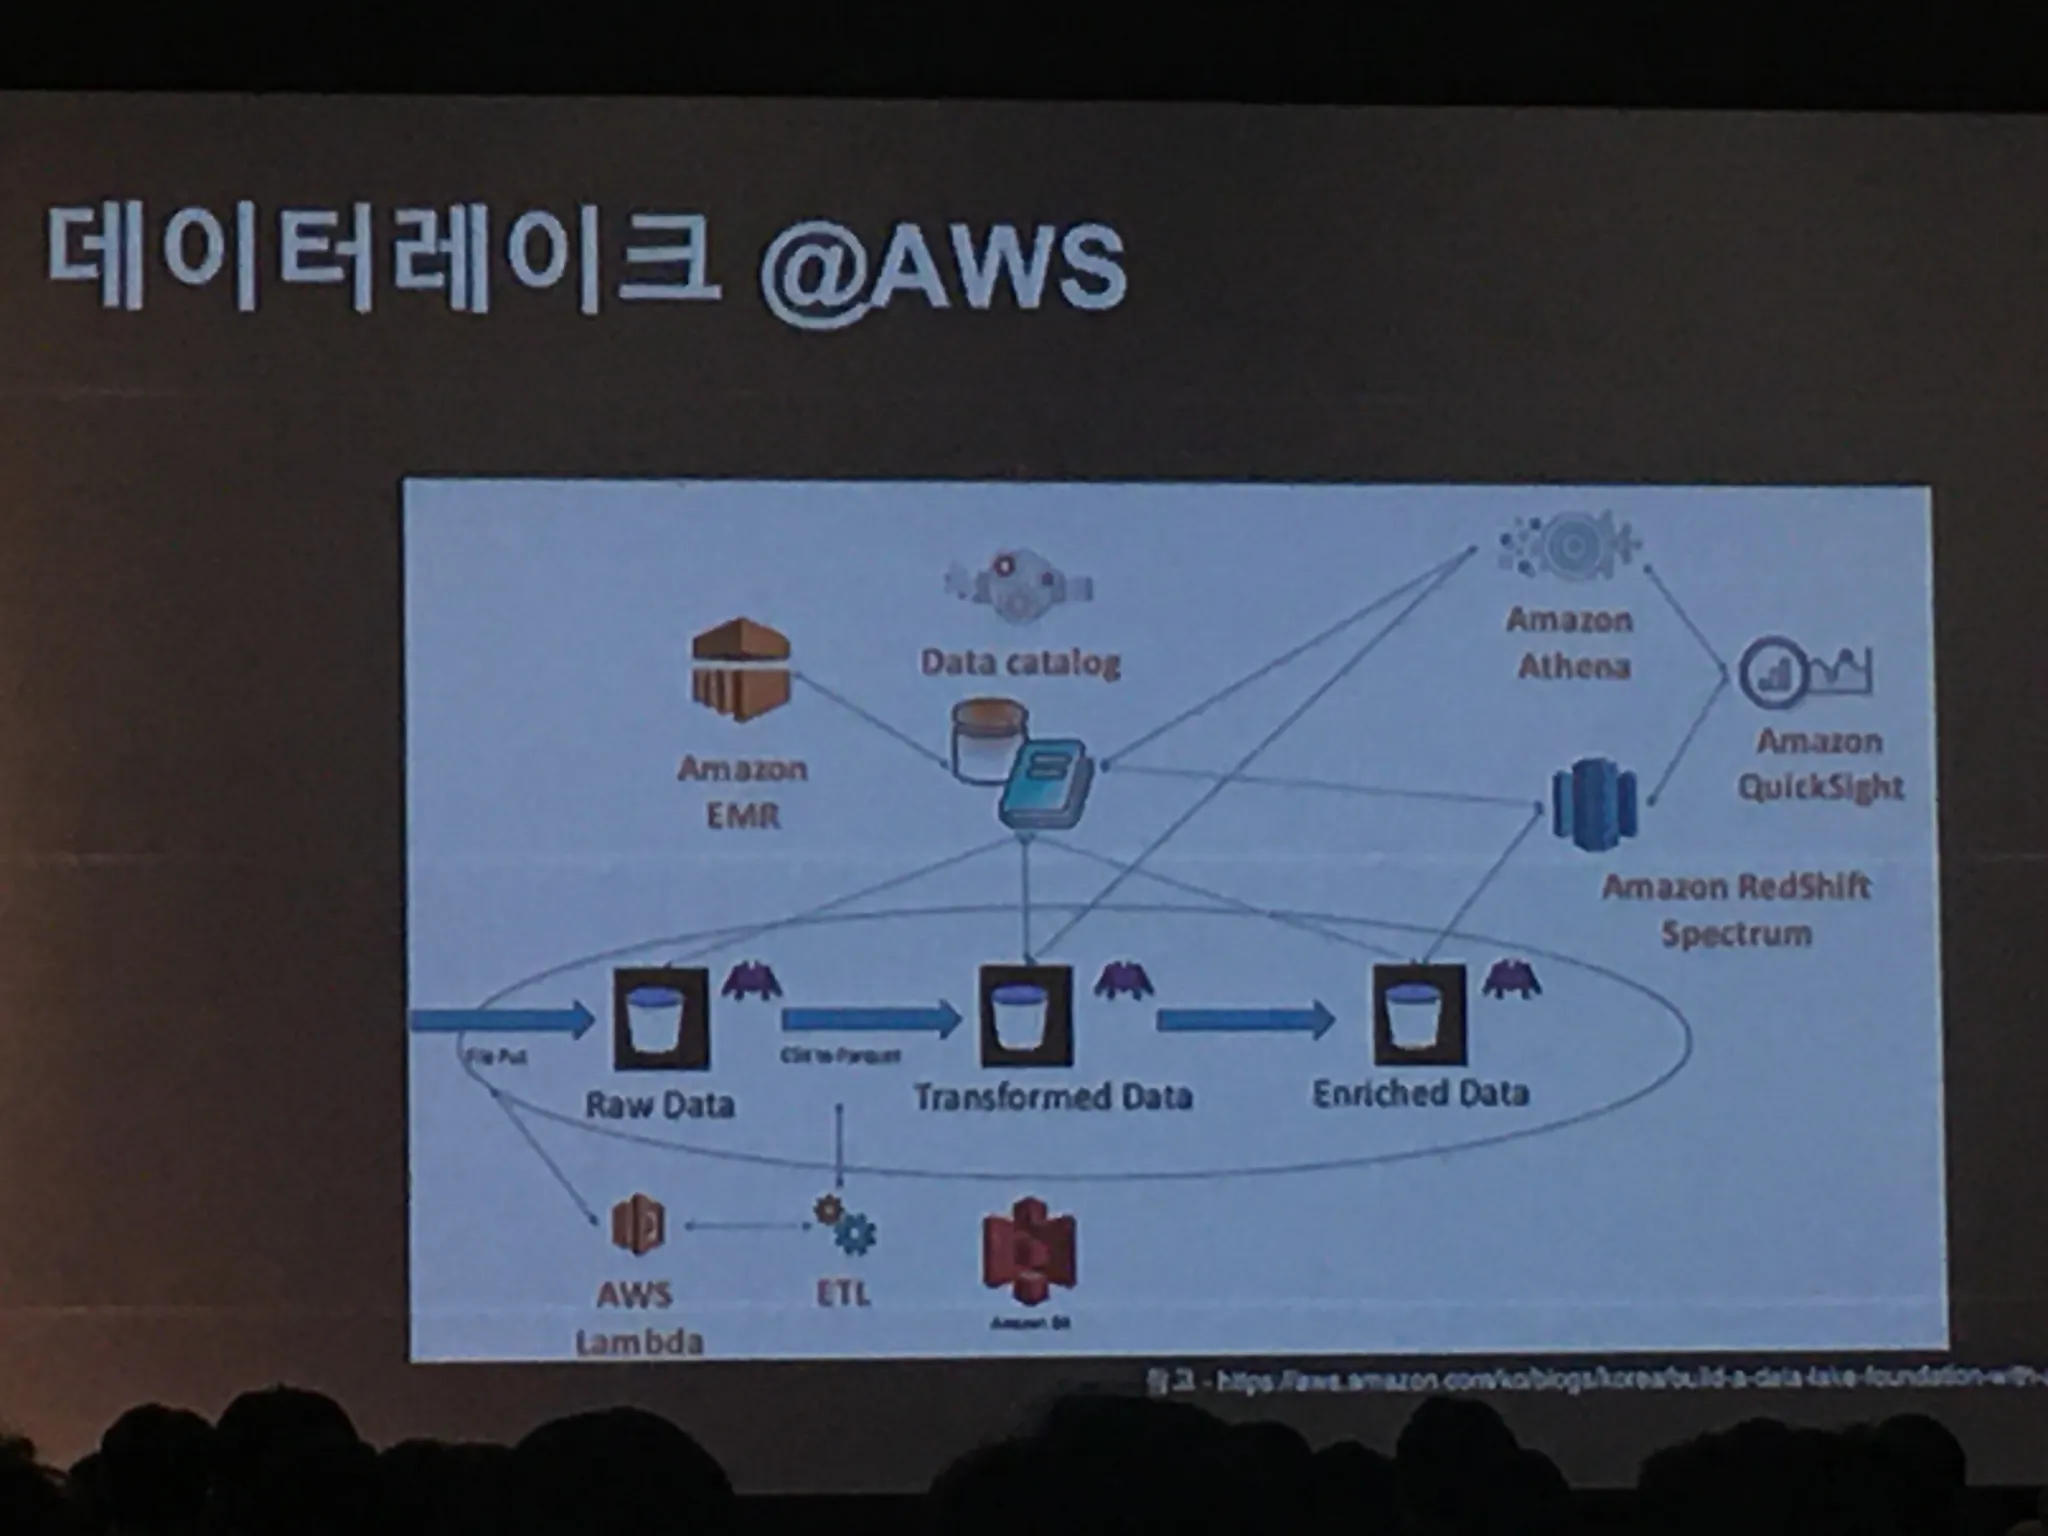
데이터 레이크, 데이터 옵스
- 데이터 분석을 하는 시간을 줄이고 품질을 줄이기 위해서 모든 역량을 투입하고, 그 역량을 갖기 위해서 자동화 시키고 프로세스 기반의 방법론
- DataOps Manifesto
- 지속적으로 고객을 만족시켜라
- 분석을 가치있게 생각해라
- 변호 수용
- 다양한 역할, 기술, 도구 수용
- 매일 협력
- 자기주도
- 영중주의를 줄여라
- 반성하라
- 분석은 코드다
- 결합하라
- 재현 가능하게 만들어라
- 비용 최소화
- 단순성
- 분석은 제조와 같다
- 품질 제일 중요
- 품질 및 성능을 모니터링
- 재사용
- 사이클 타임을 개선
- 이상적인 DataOps
- 목표를 중심으로 스스로 조직
- 도구, 데이터, 인력 등 모두 장악이 필요함
- 모든 데이터를 한곳으로 다 모으고, 다양한 이해 관계자와 함께 데이터를 활용할 수 있는 플랫폼을 개발
아키텍처
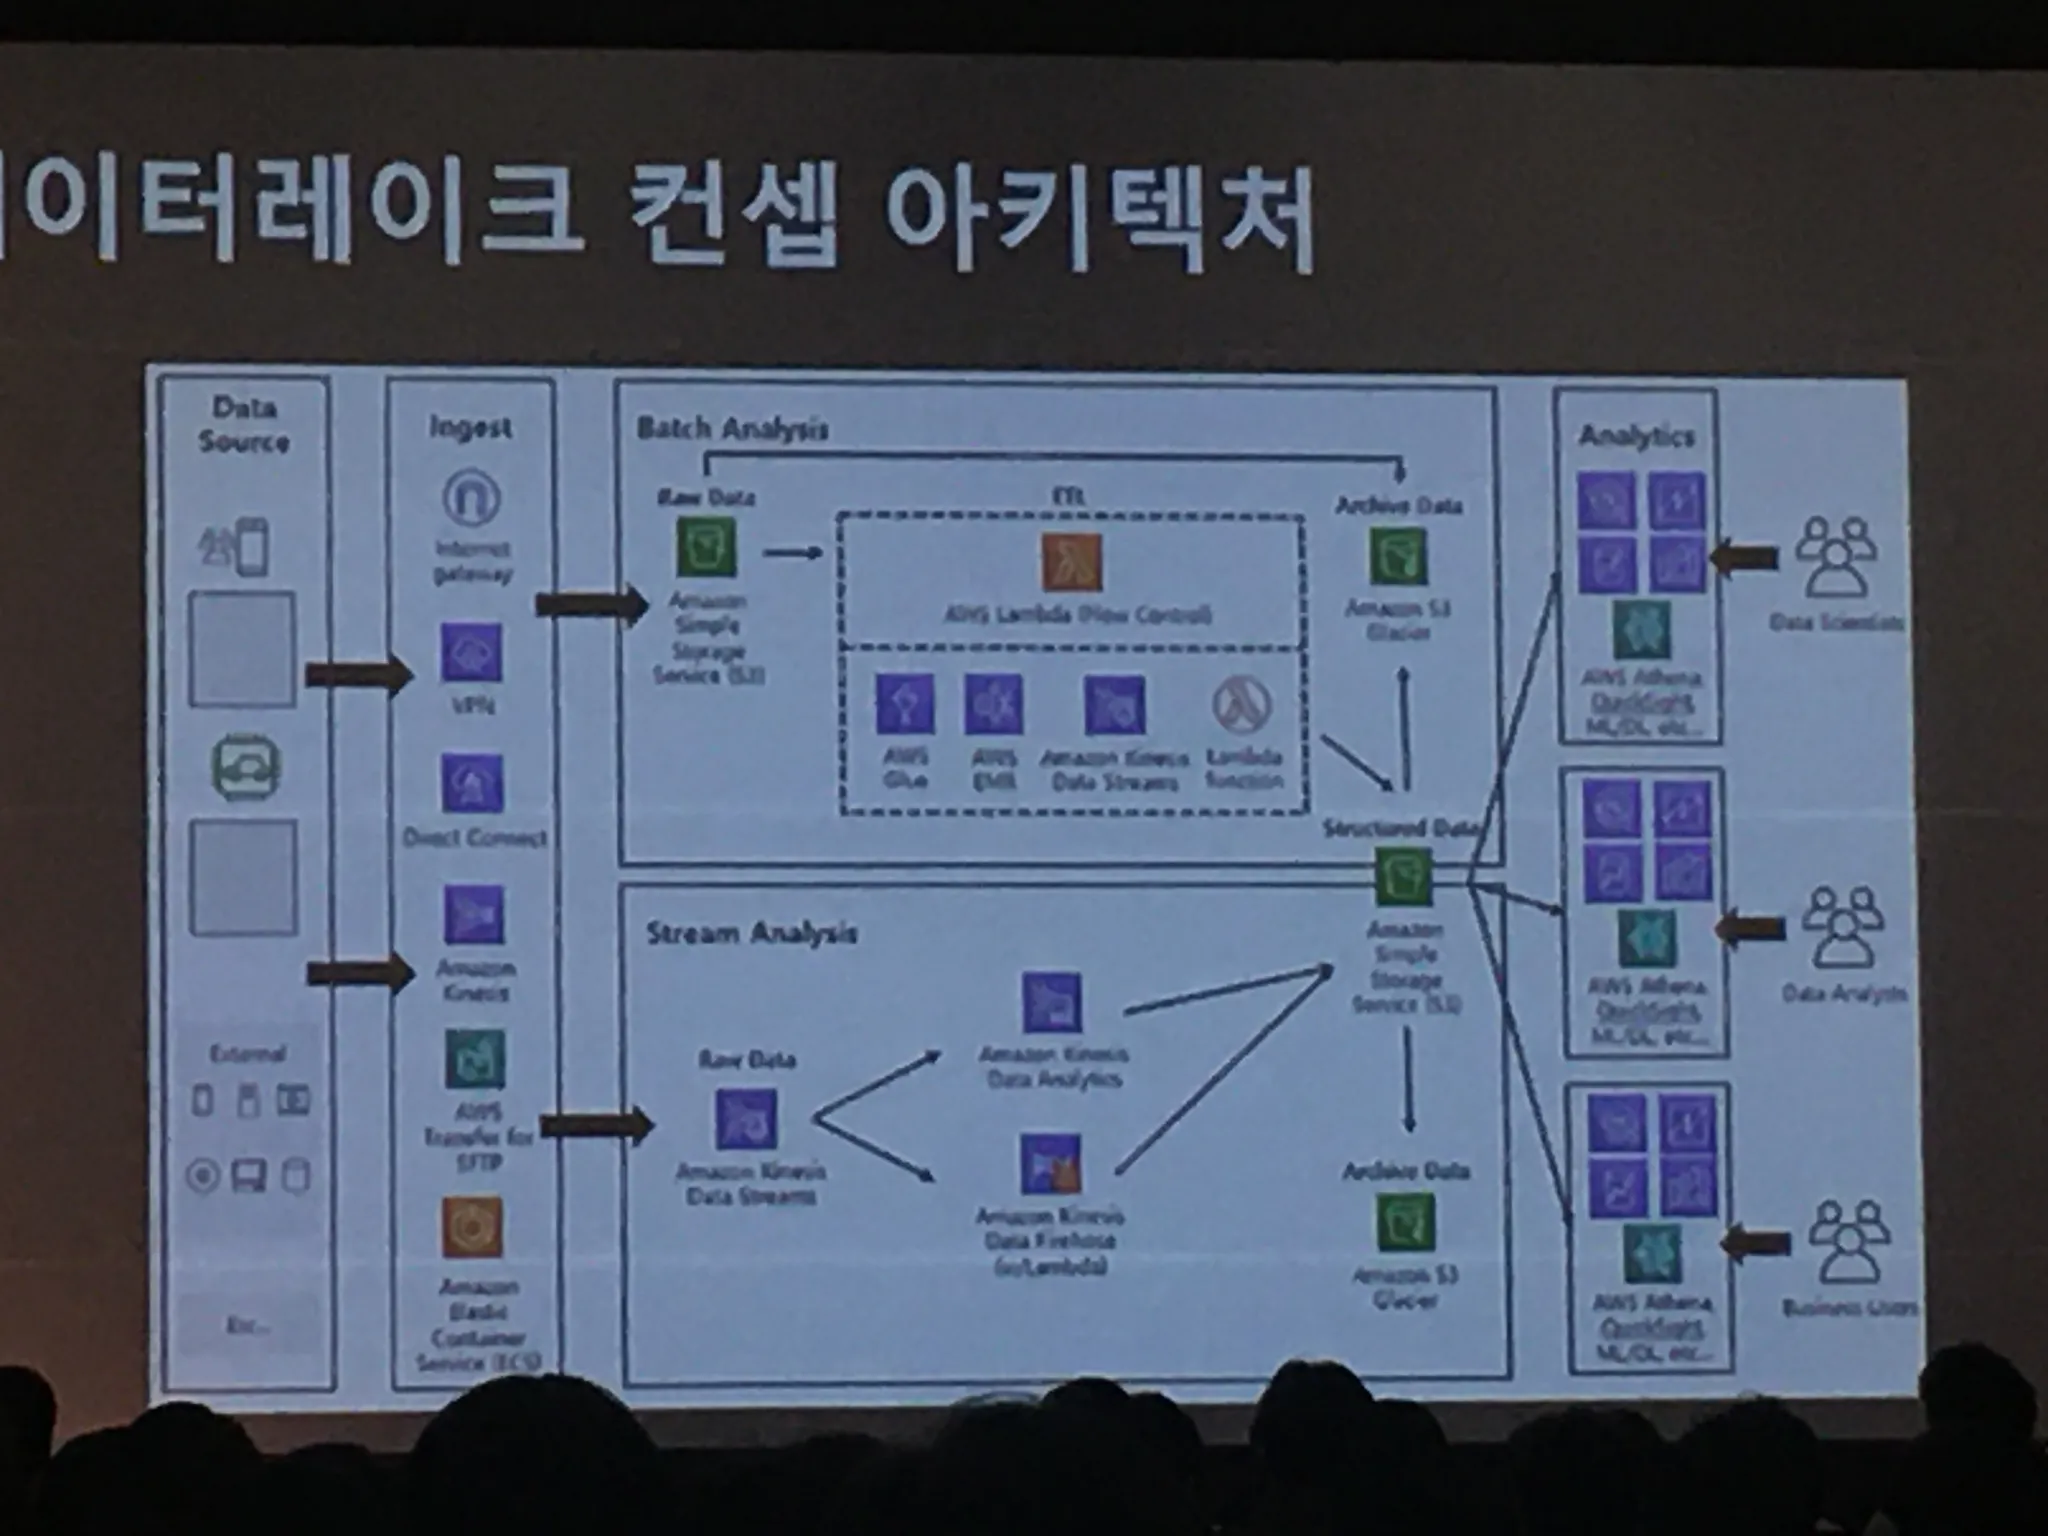
- 설계 고려 사항
- No-Ops : 관리형 서비스를 사용
- GitOps : 모든 인프라, 코드, 스크립트들을 관리
- Automation : 자동화
S3 데이터 레이크
- 구성 사례: AWS Glue 를 사용하여 완전한 서버리스 데이터 웨어하우스로 전환 ( woot.com 예시 )
S3 기반 수집, 처리, 분석
데이터 수집
-
Batch서비스를 활용- 어떤 규모로든 확장 가능한 완전 관리형 배치 컴퓨팅
-
구성 사례: 모바일 앱 데이터를 수집하기 위한 타 클라우드 연동 아키텍처
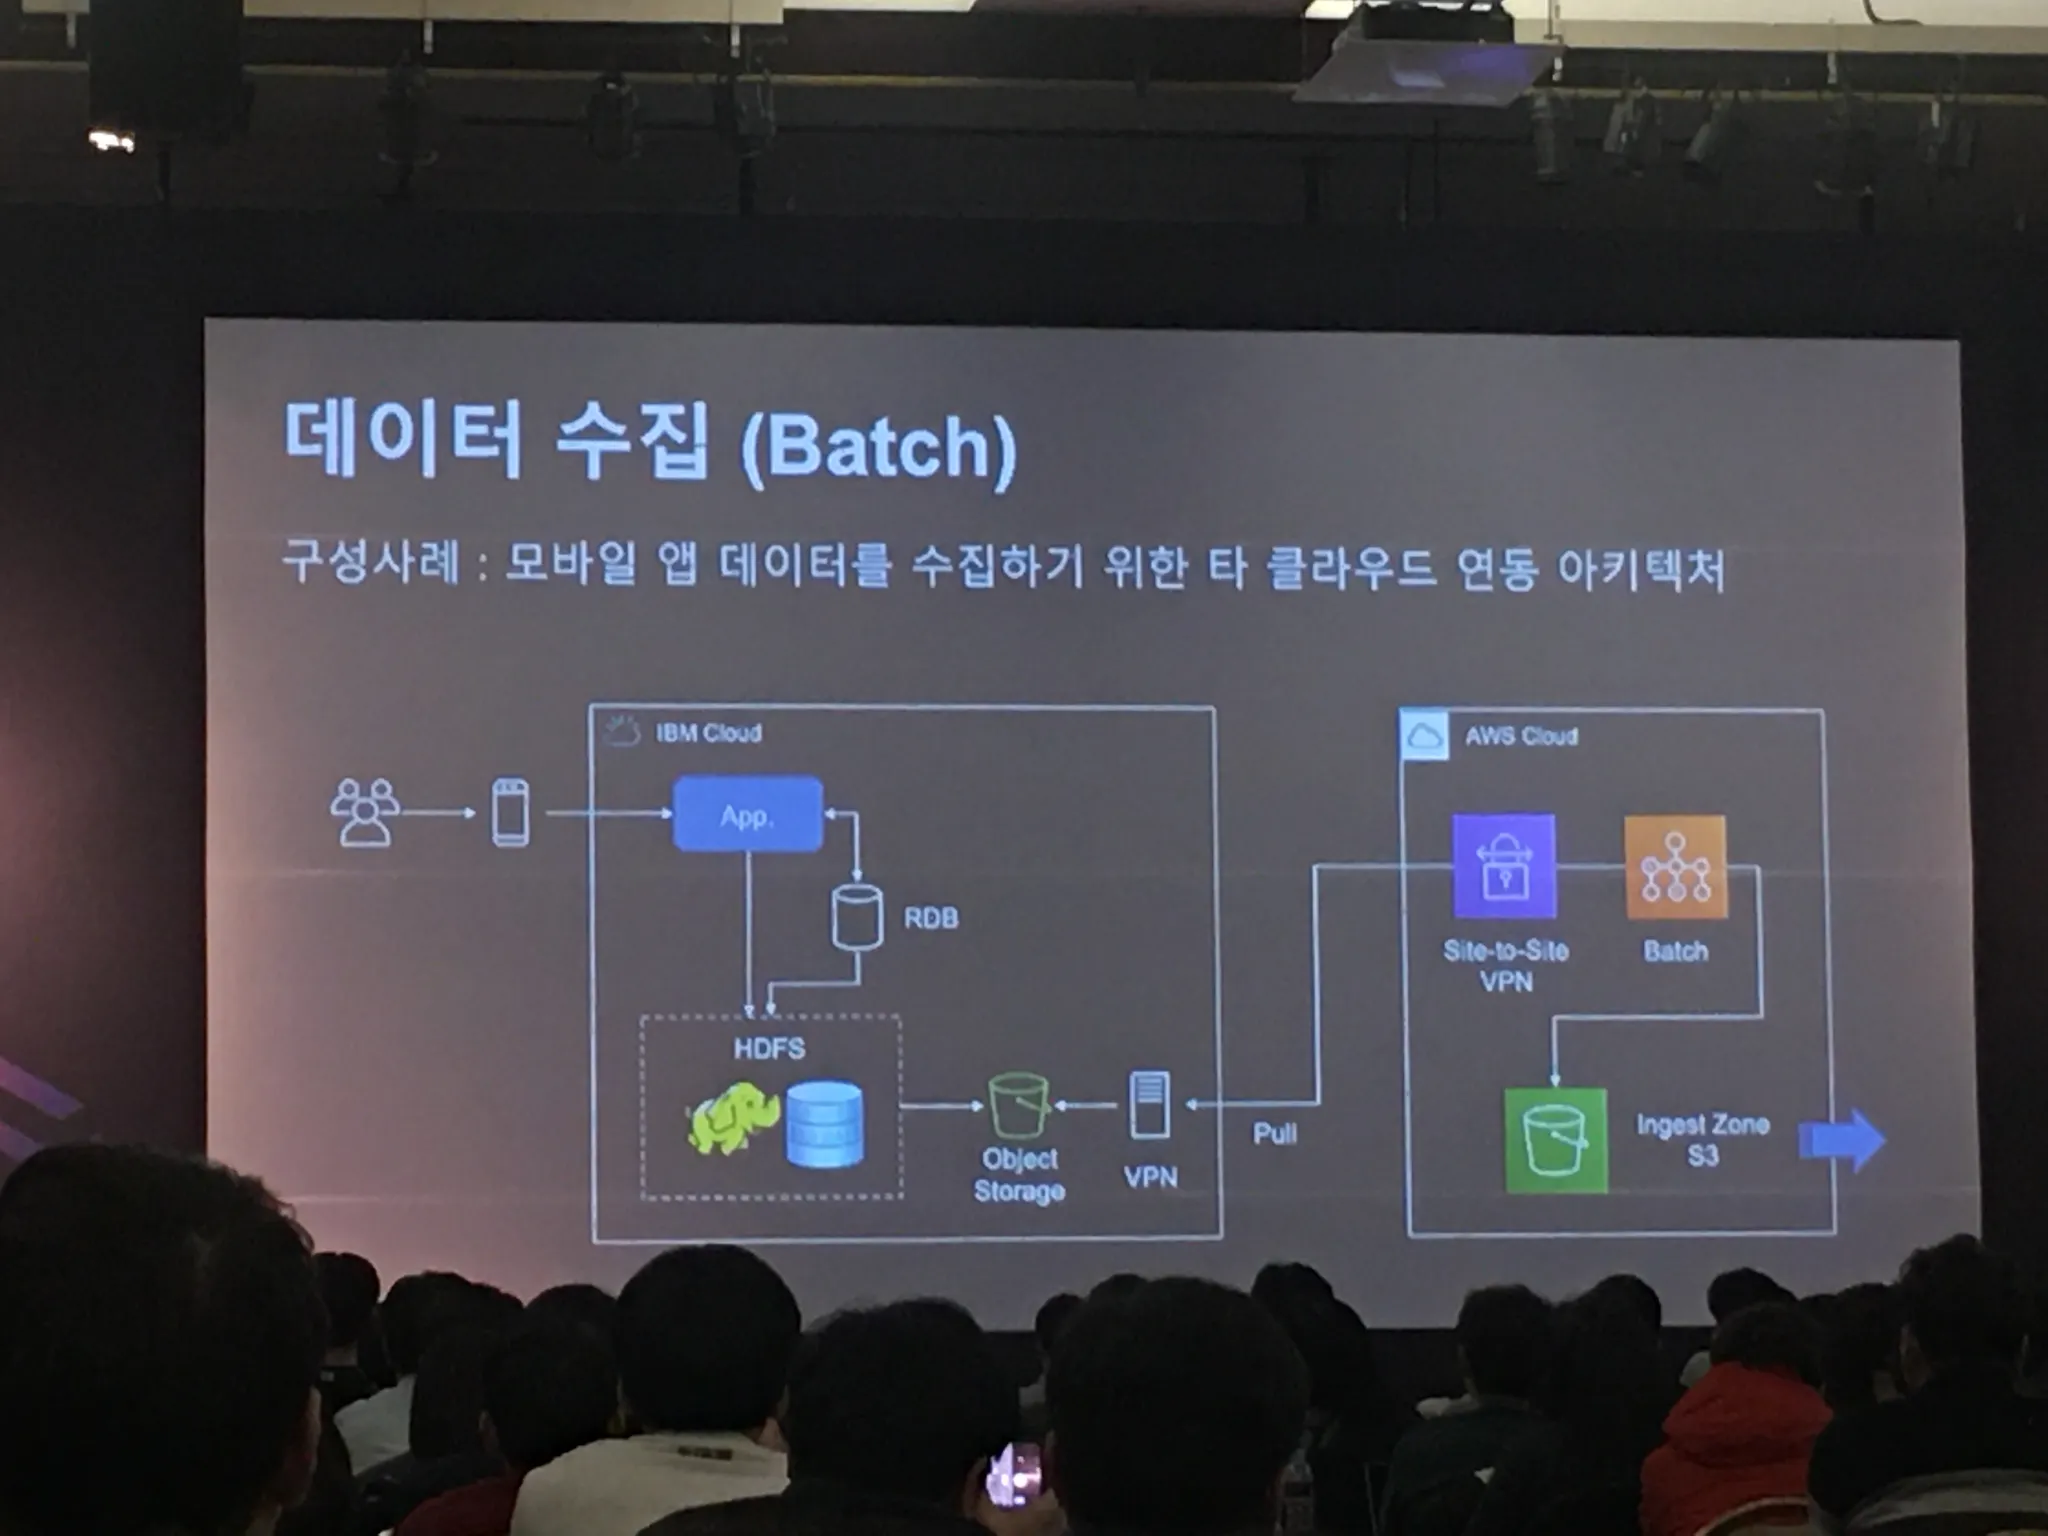
-
구성 사례: 외부 API 연동 아키텍처 ( Fully Managed Service )
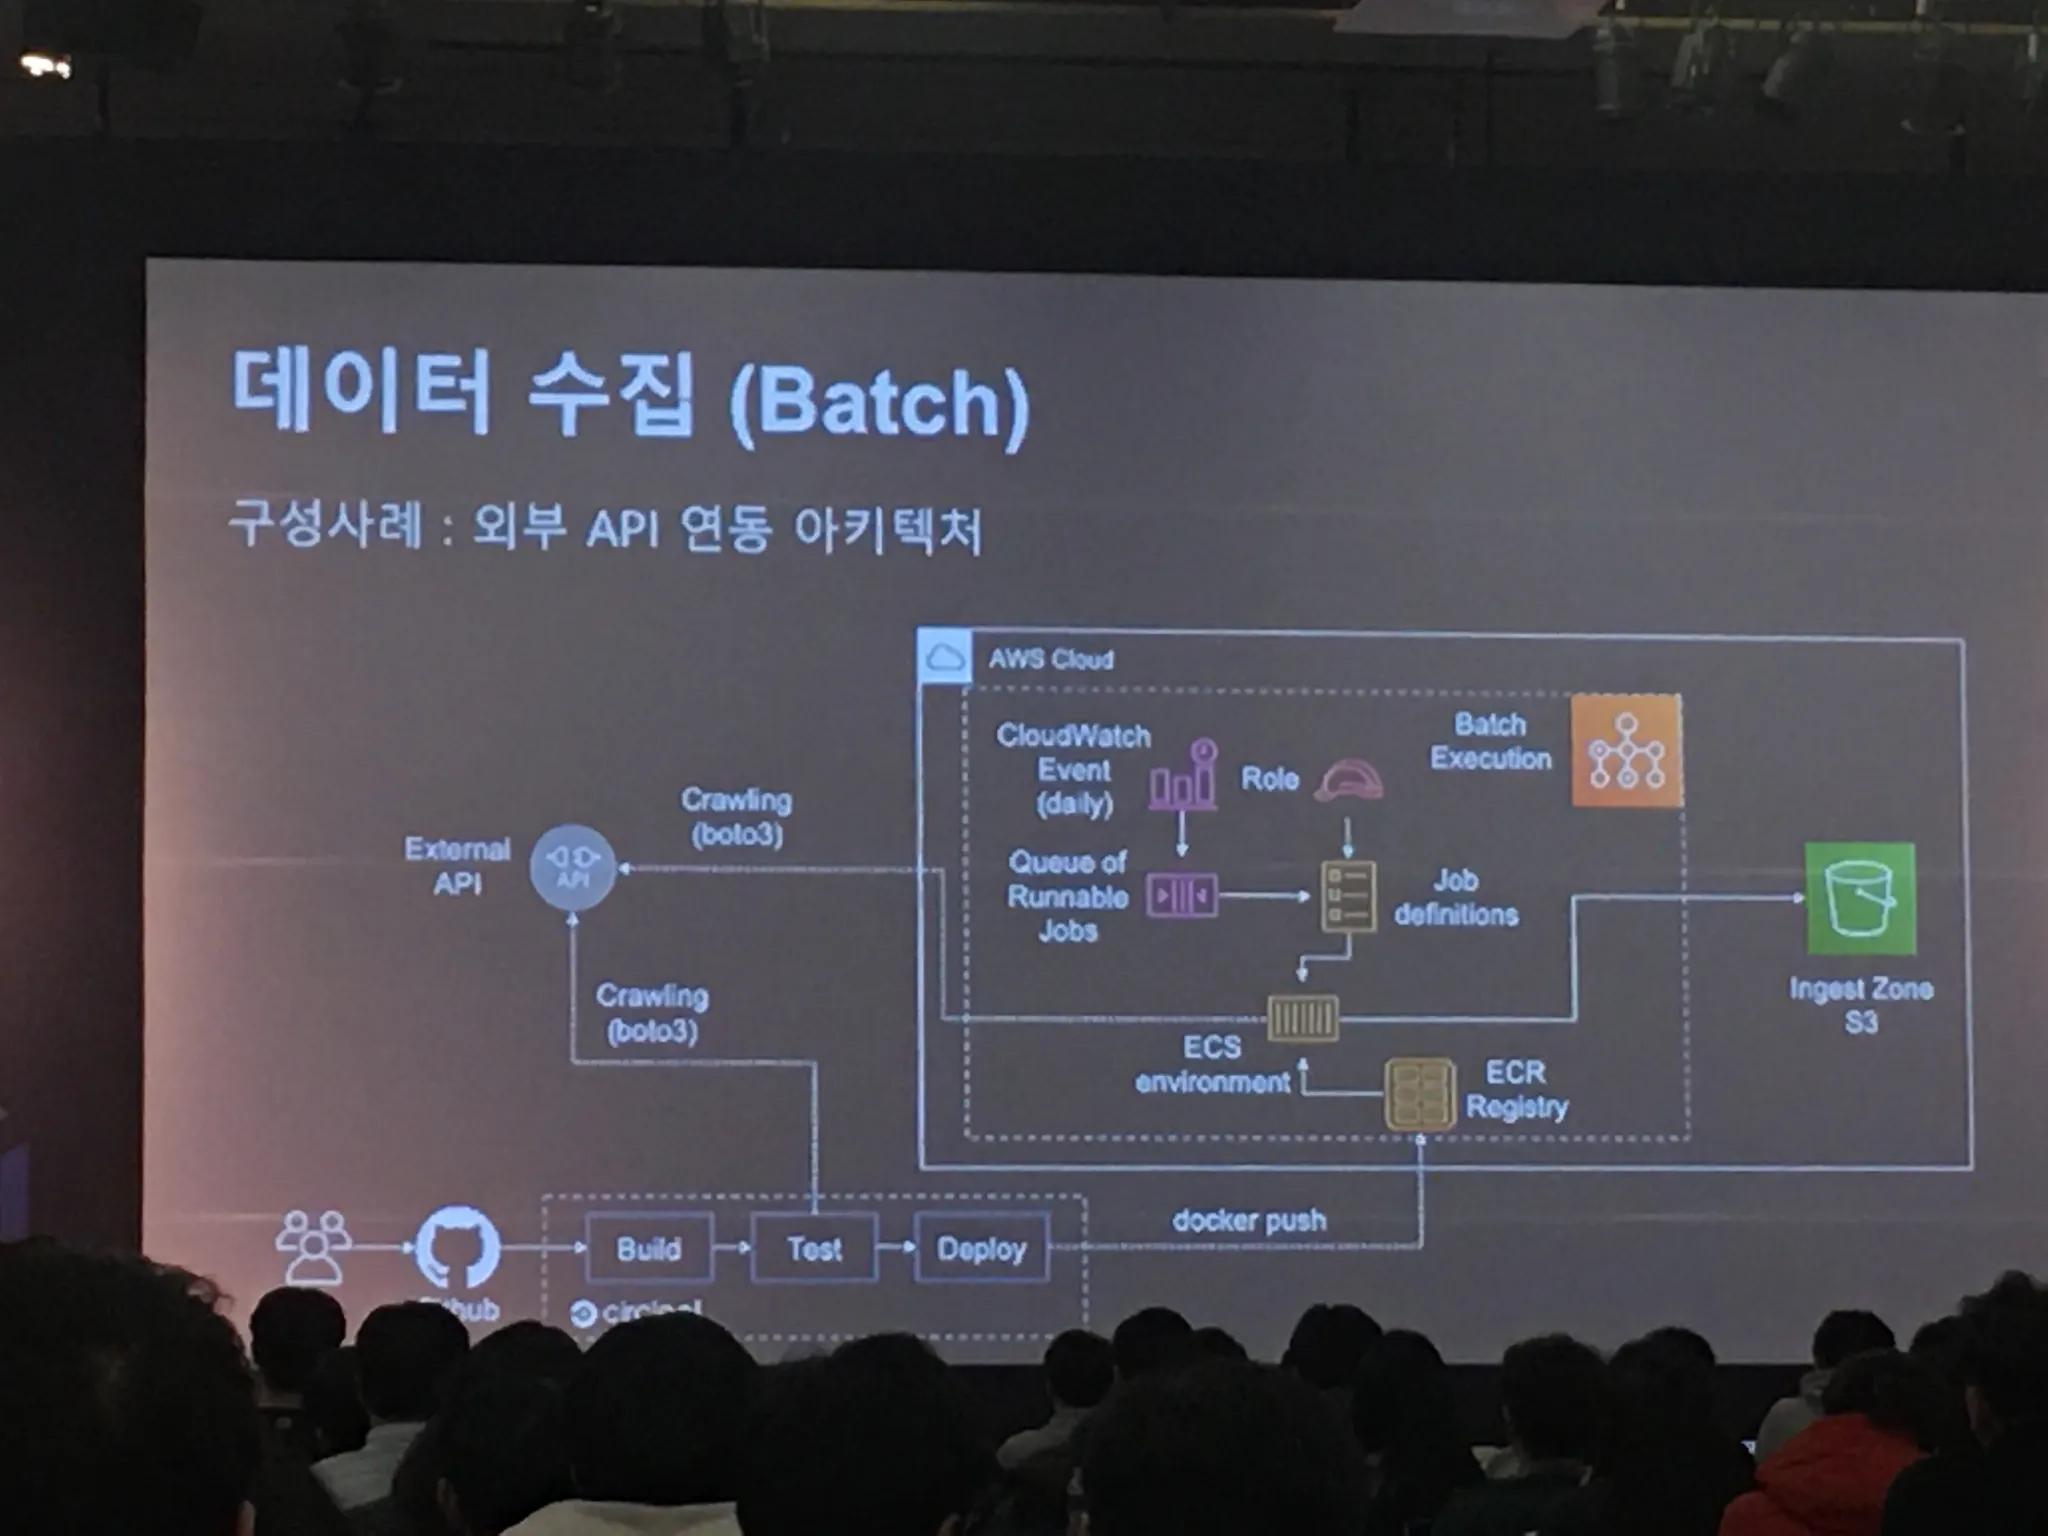
-
스트리밍 데이터 ( Kinesis Data Firehose )
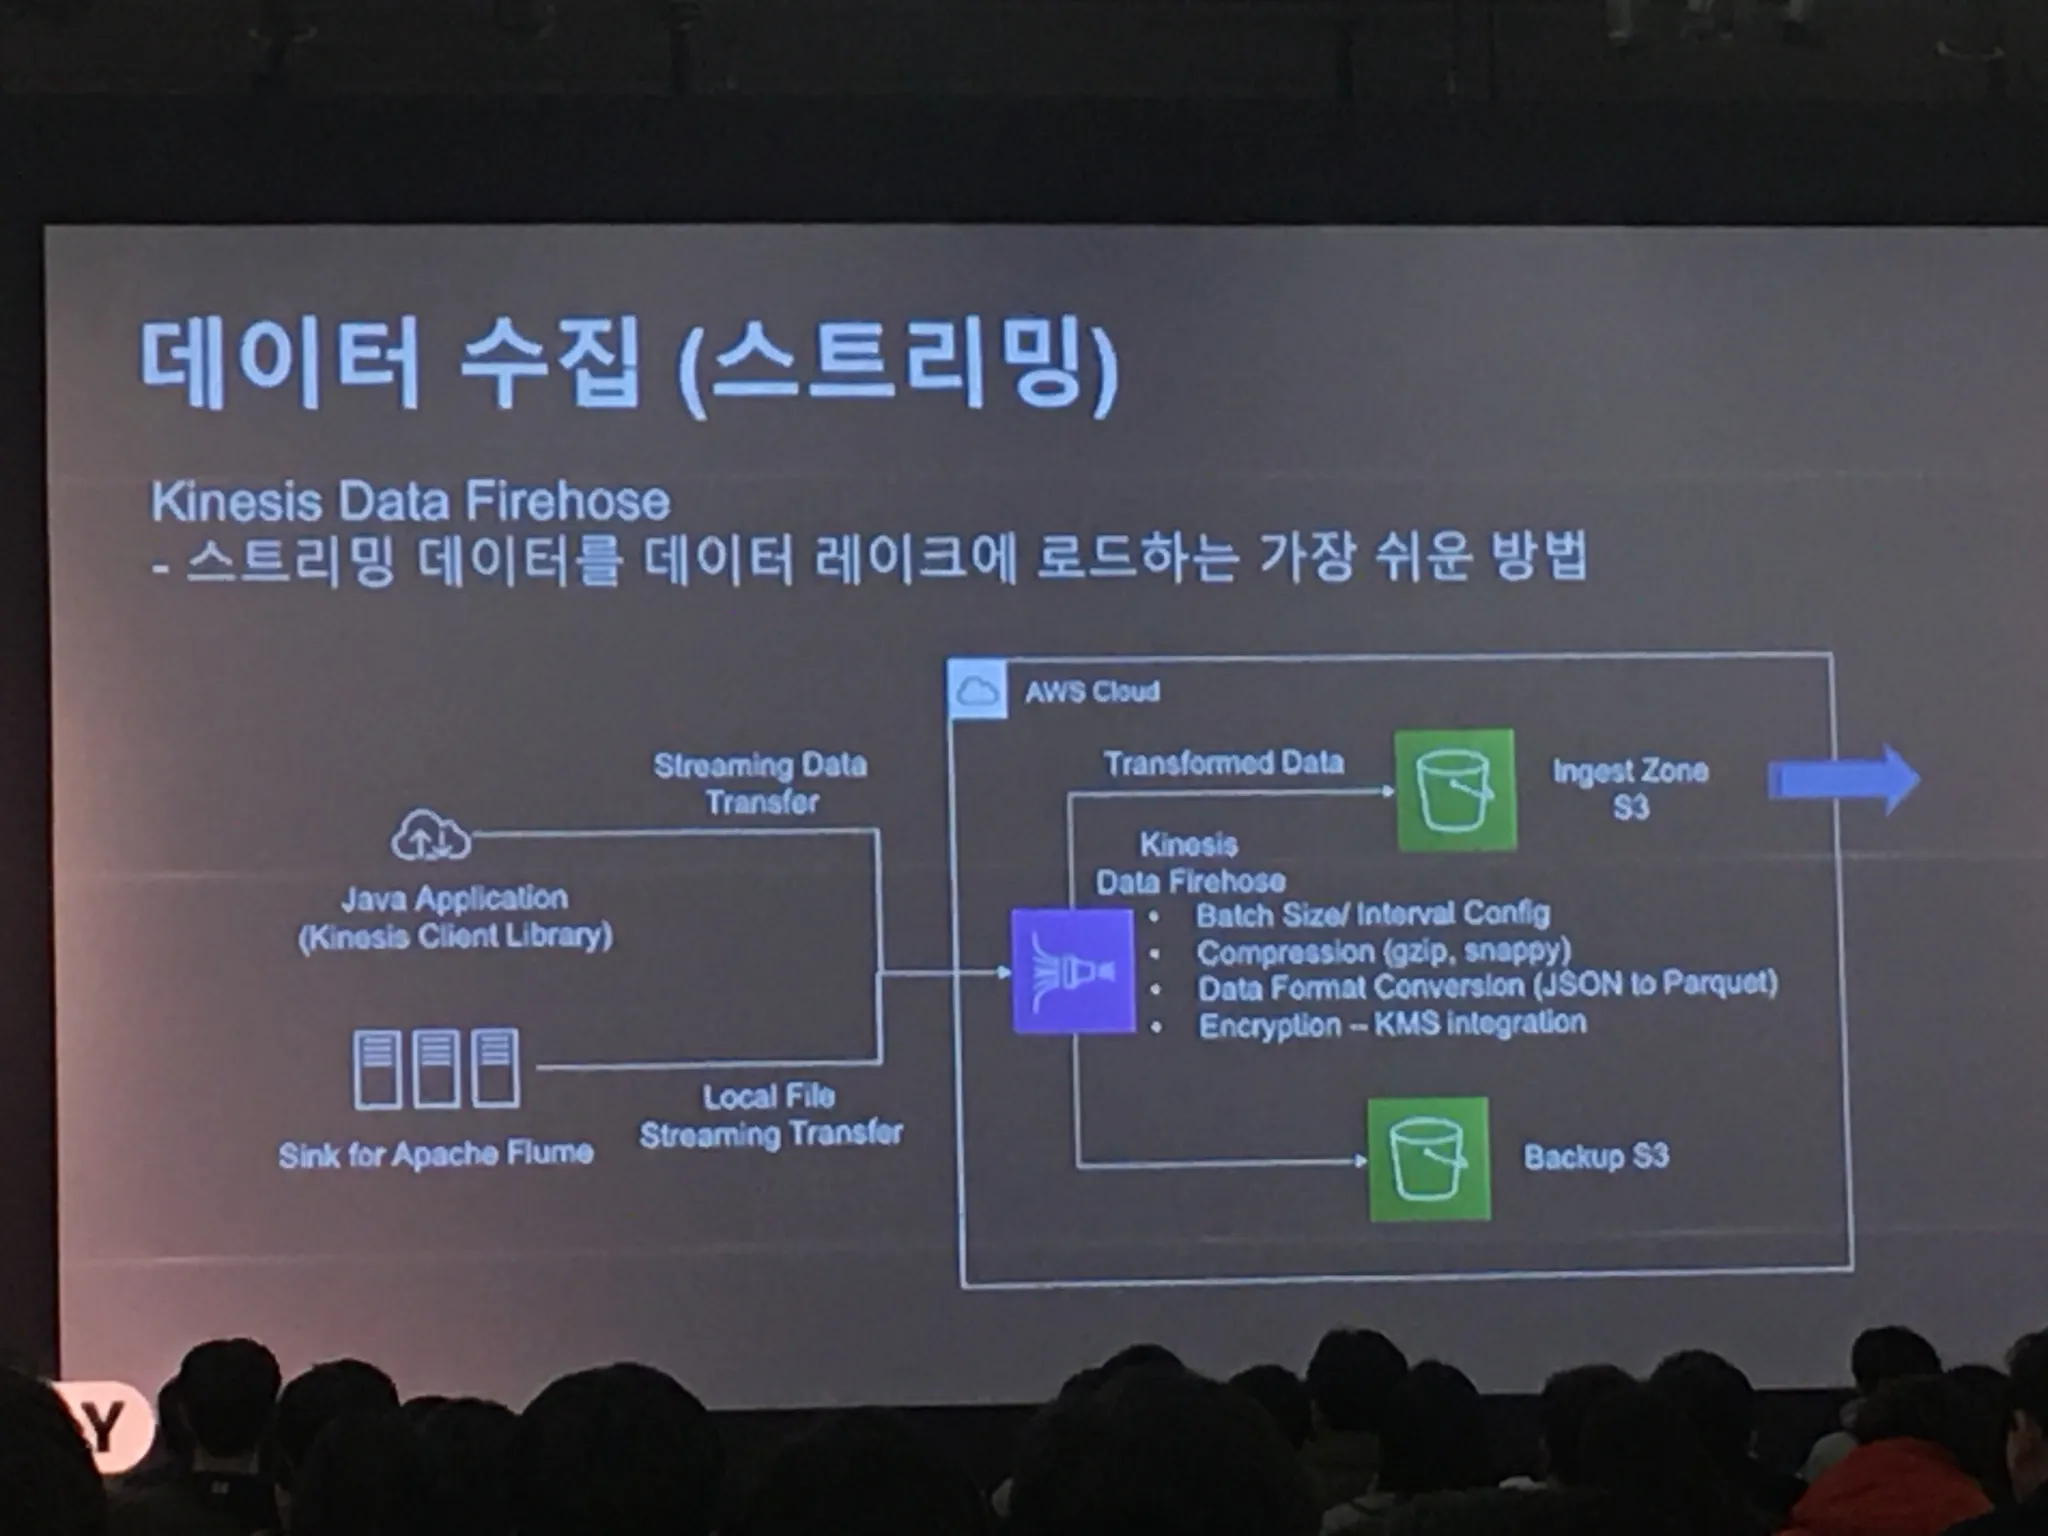
데이터 처리
-
비정형 데이터 → 정형 데이터 rhksfl
-
Glue 서비스를 적극 사용
- 분석을 위해 손쉽게 데이터를 준비하고 로드할 수 있게 지원하는 완전관리형 ETL ( 추출, 변환, 로드 ) 서비스
-
구성 사례: 이벤트 기반 Glue 파이프라인 구성
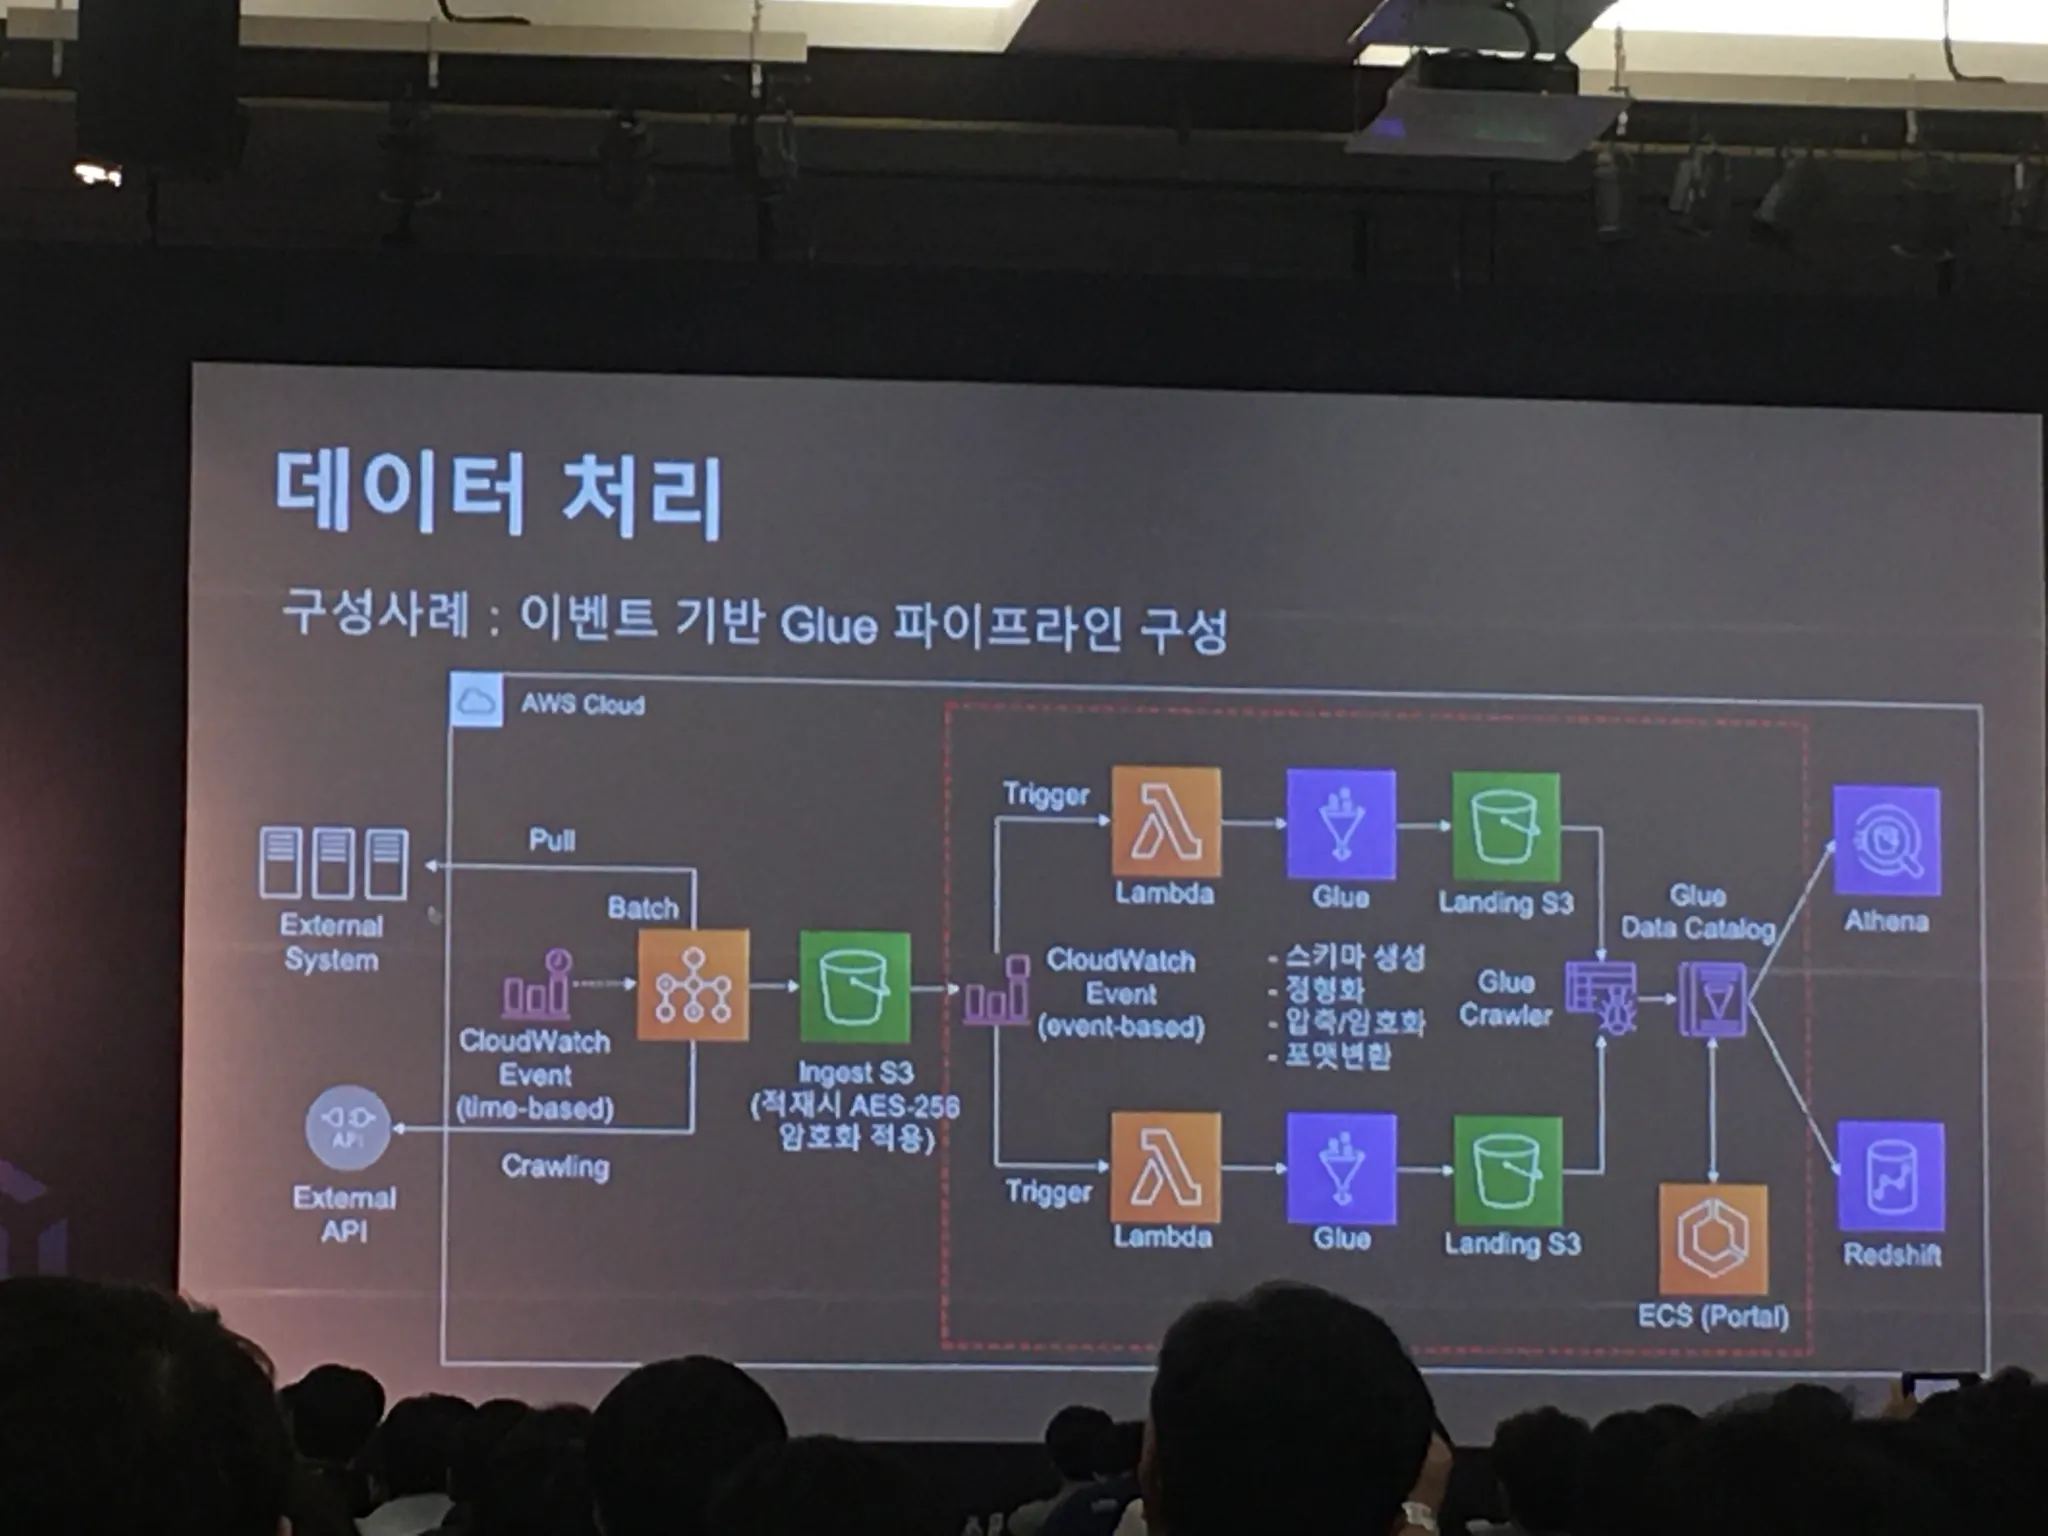
데이터 분석
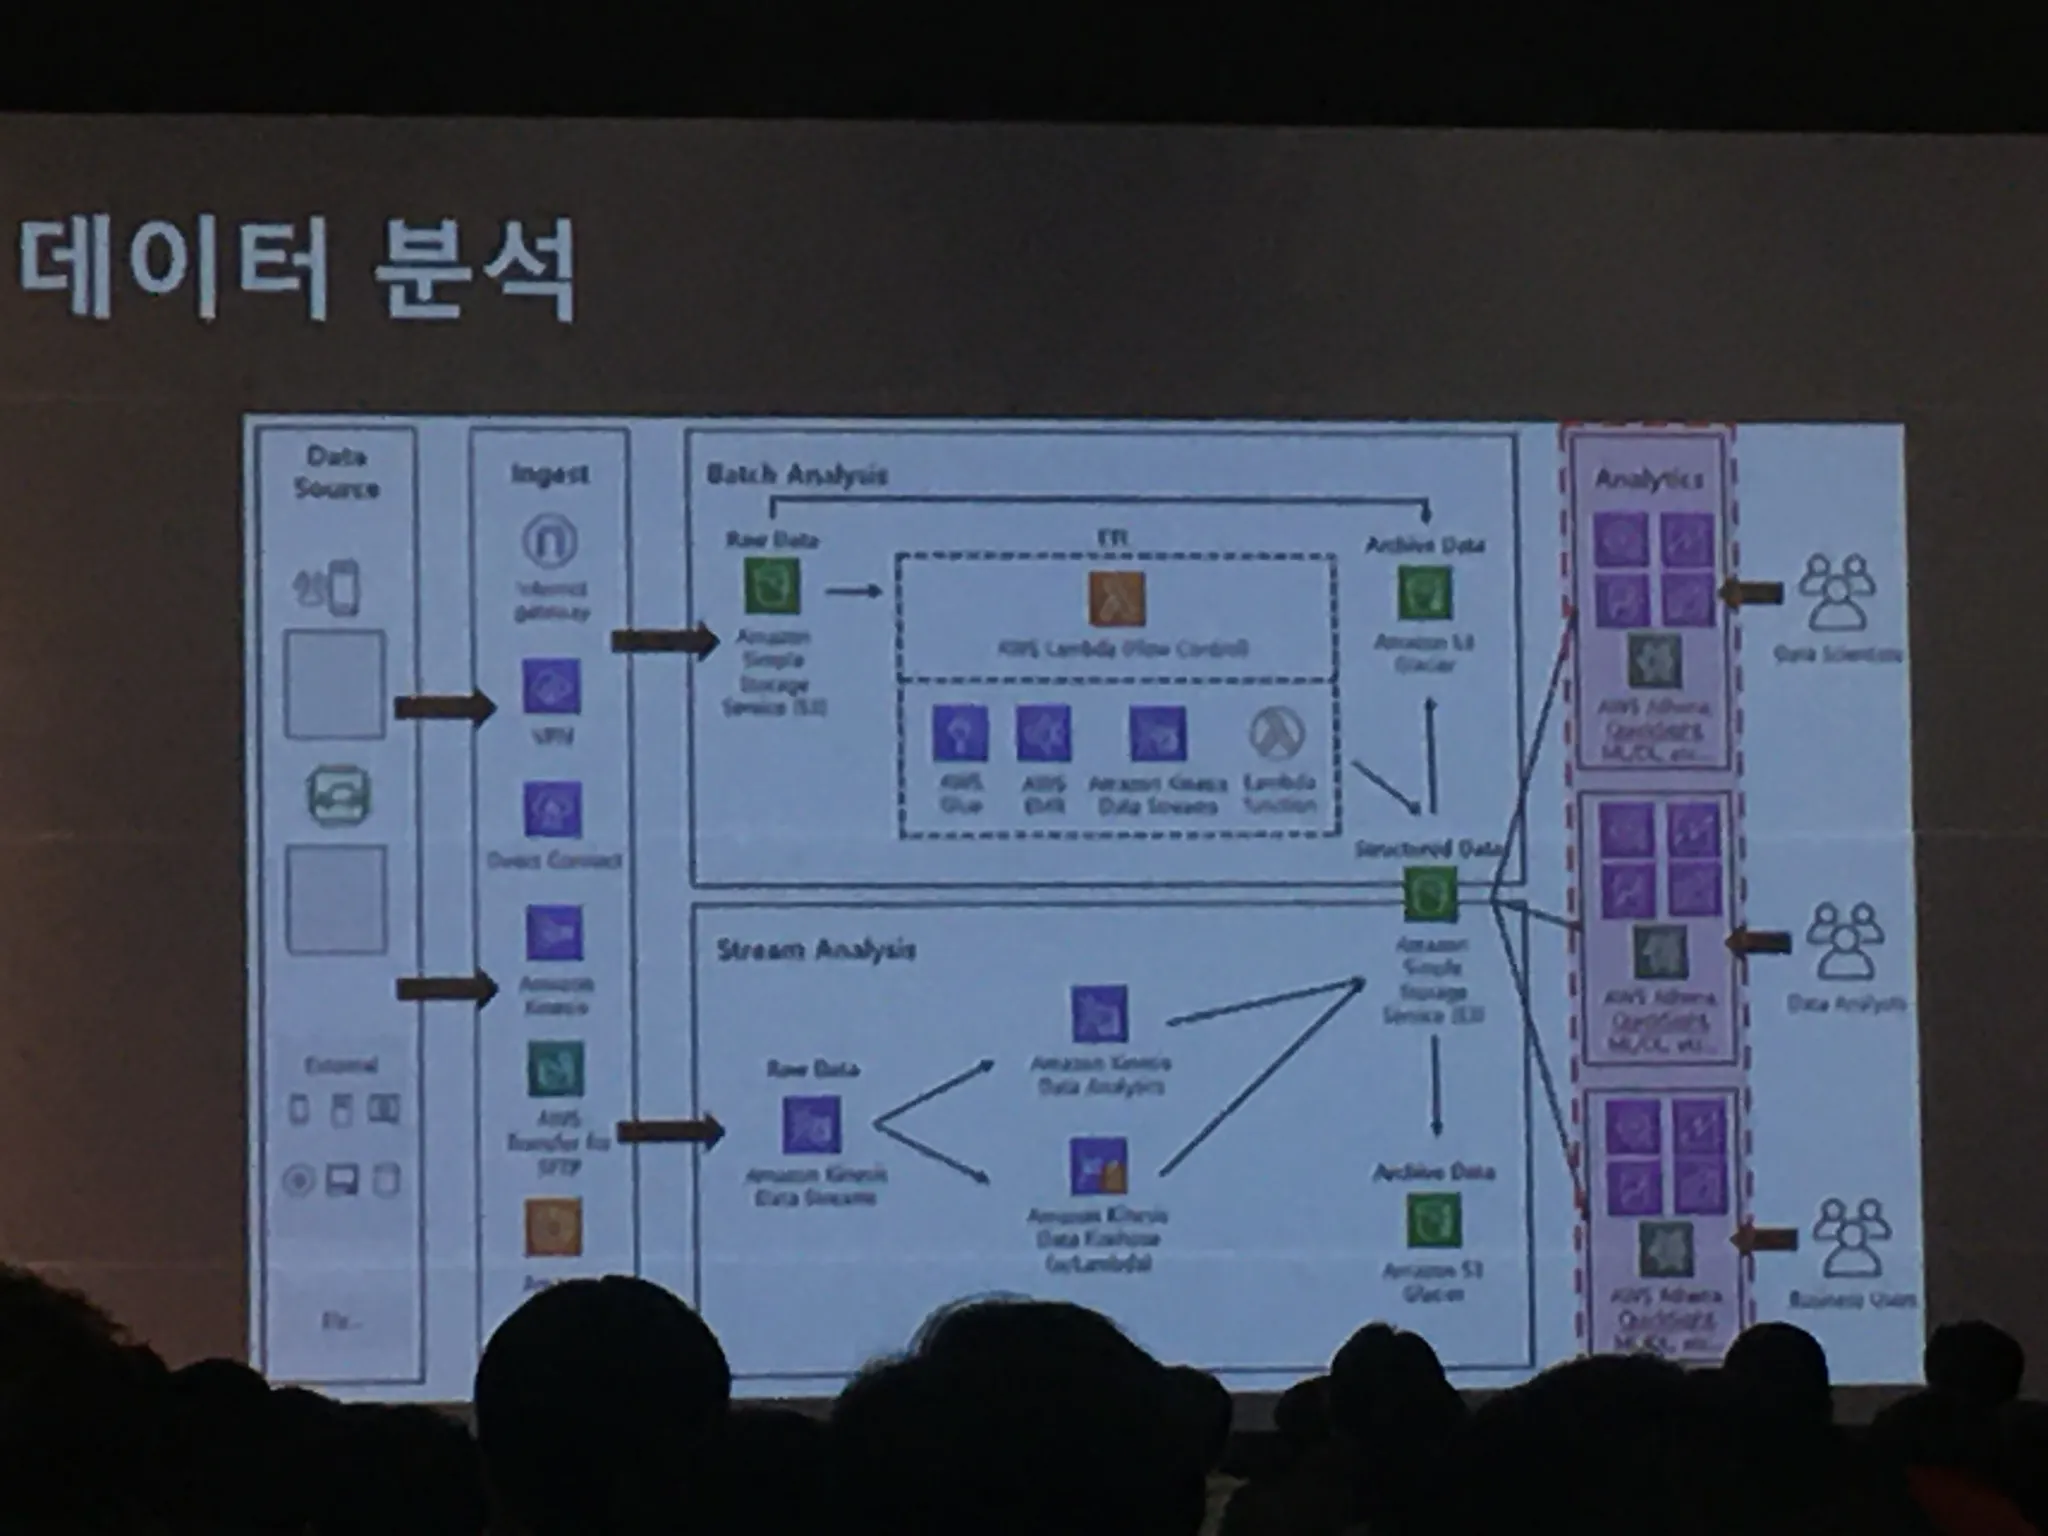
-
SageMaker
- 기계 학습 모델을 빠르고 쉽게 구축, 훈련하고 배포까지 지원하는 서비스
-
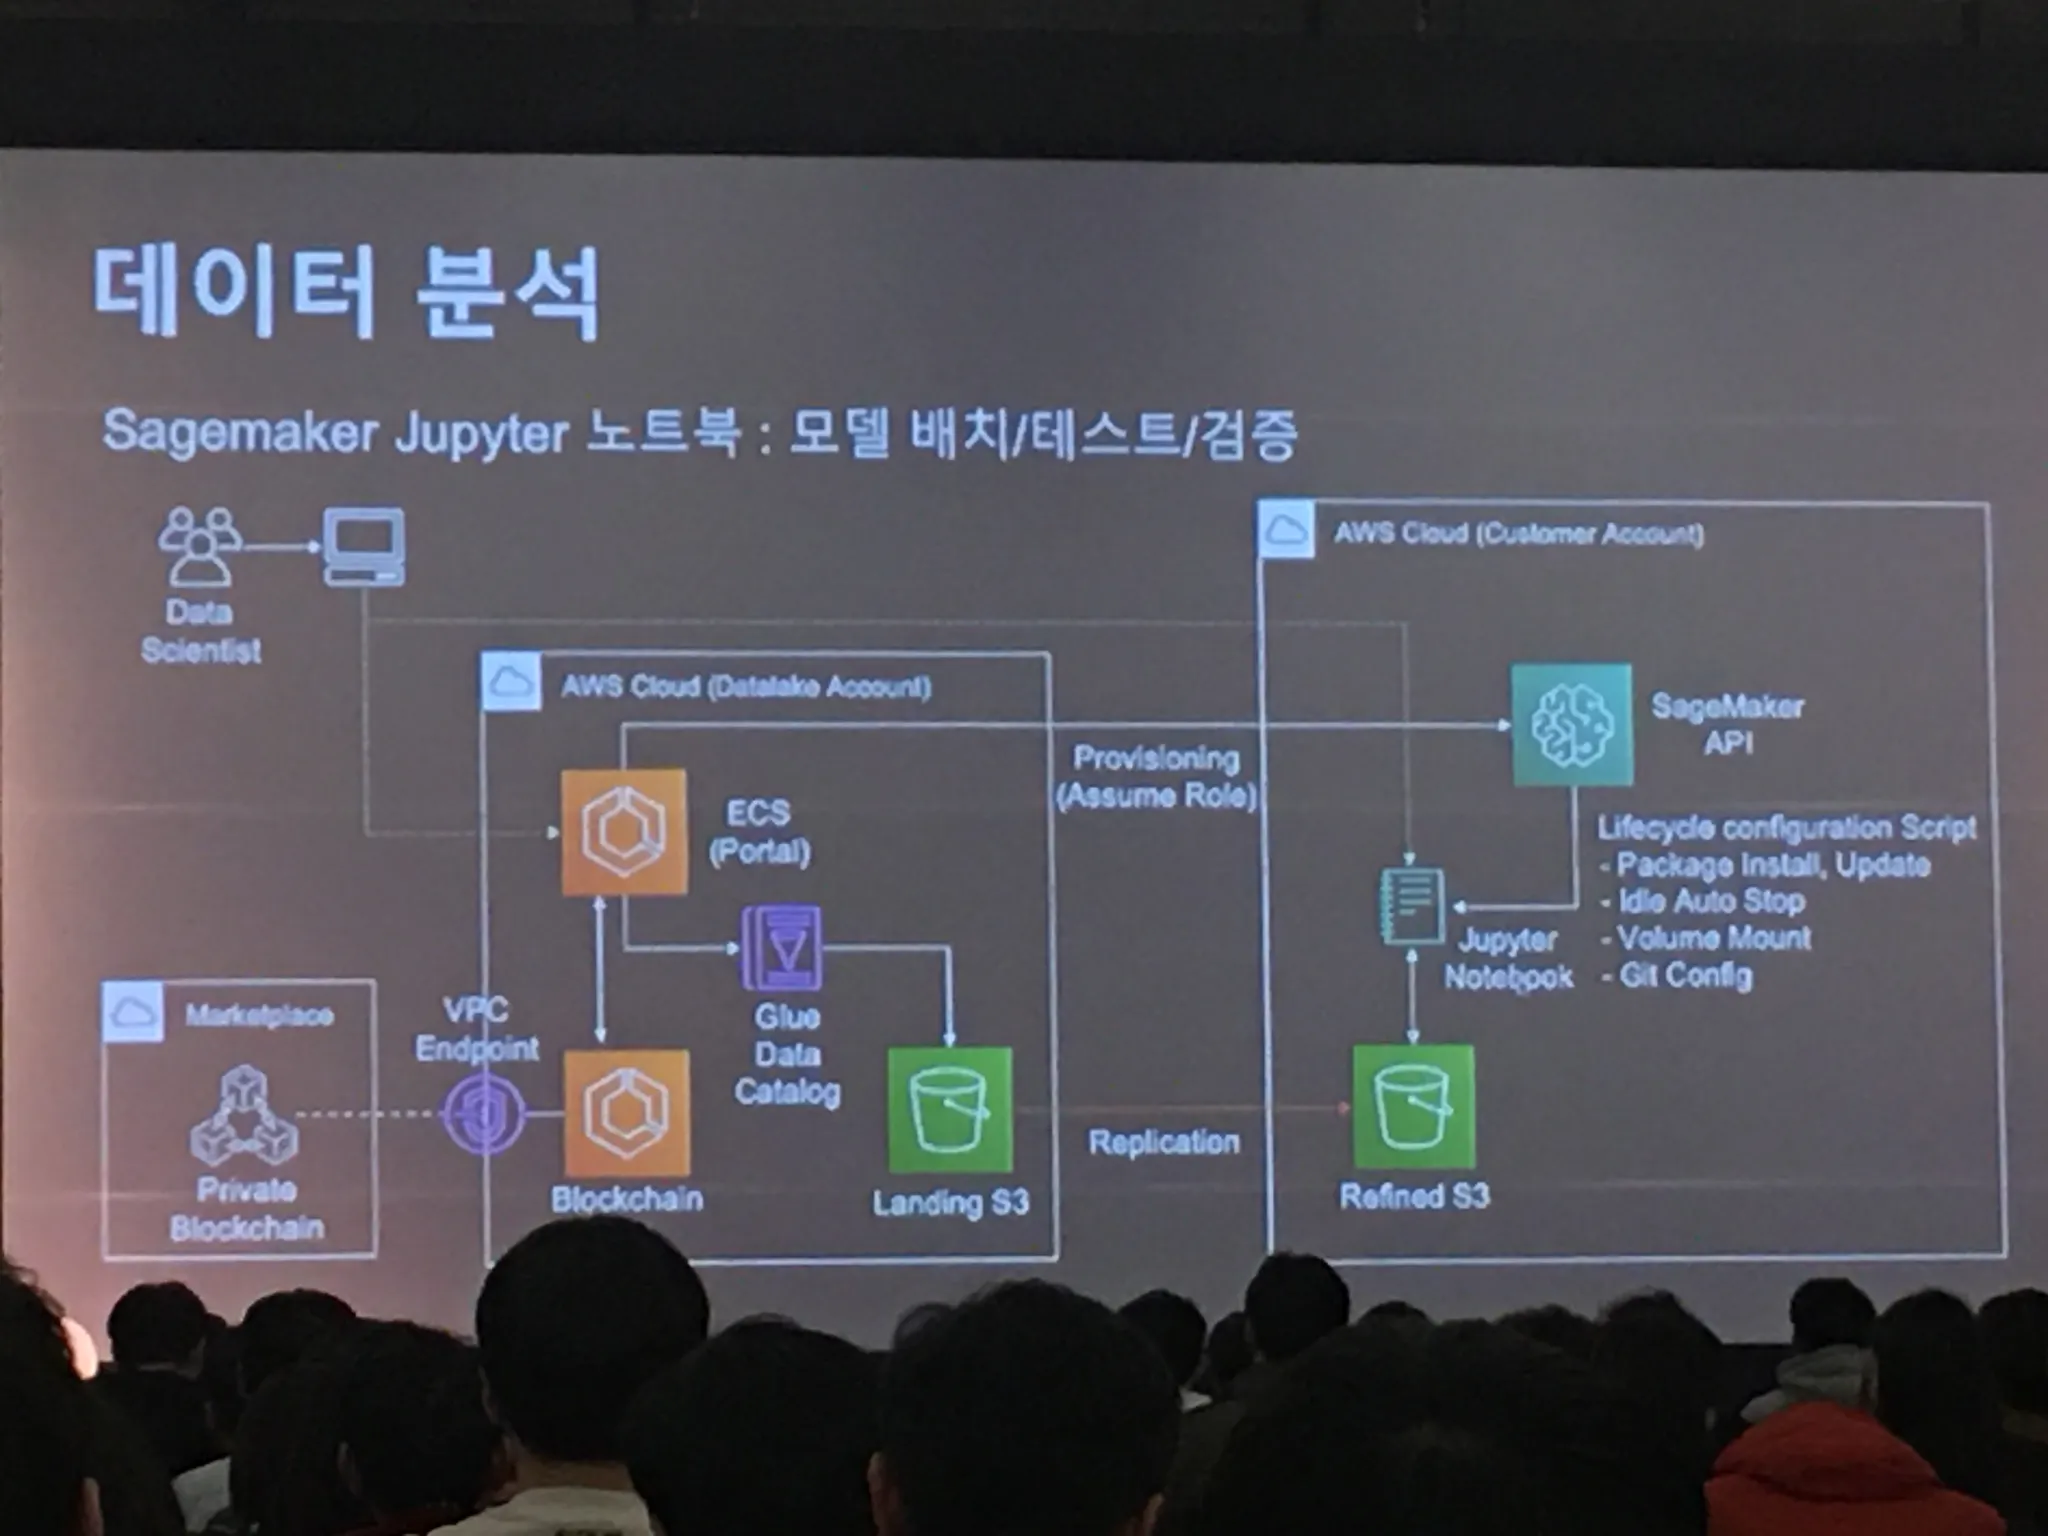
SageMaker Jupyter 노트북: 모델 배치, 테스트, 검증
- Jupyter 샌드박스 제공
- LifeCycle 구성 스크립트 활용하여 사전 환경 구성
- 사용량 빌링을 위한 Cost Explorer API 연동
- Assume Role 을 활용한 원격 Account 분석환경 구성
-
SageMaker Training
- 원하는 알고리즘으로 학습 수행 및 모델 저장
-
엔드포인트는 지속 실행 비용 발생. Transform 은 실제 실행 때만 발생
-
BI ( Business Intelligence )
- QuickSight
- 완전관리형 클라우드 기반 BI 서비스
- SPICE ( QuickSight 용 인메모리 최적화 계산 엔진 ) 을 활용하여 주기적인 업데이트
- 3rd Party BI 활용 : RedShift - Trableau Server - 포털 연동
- QuickSight
-
데이터 포털 개발
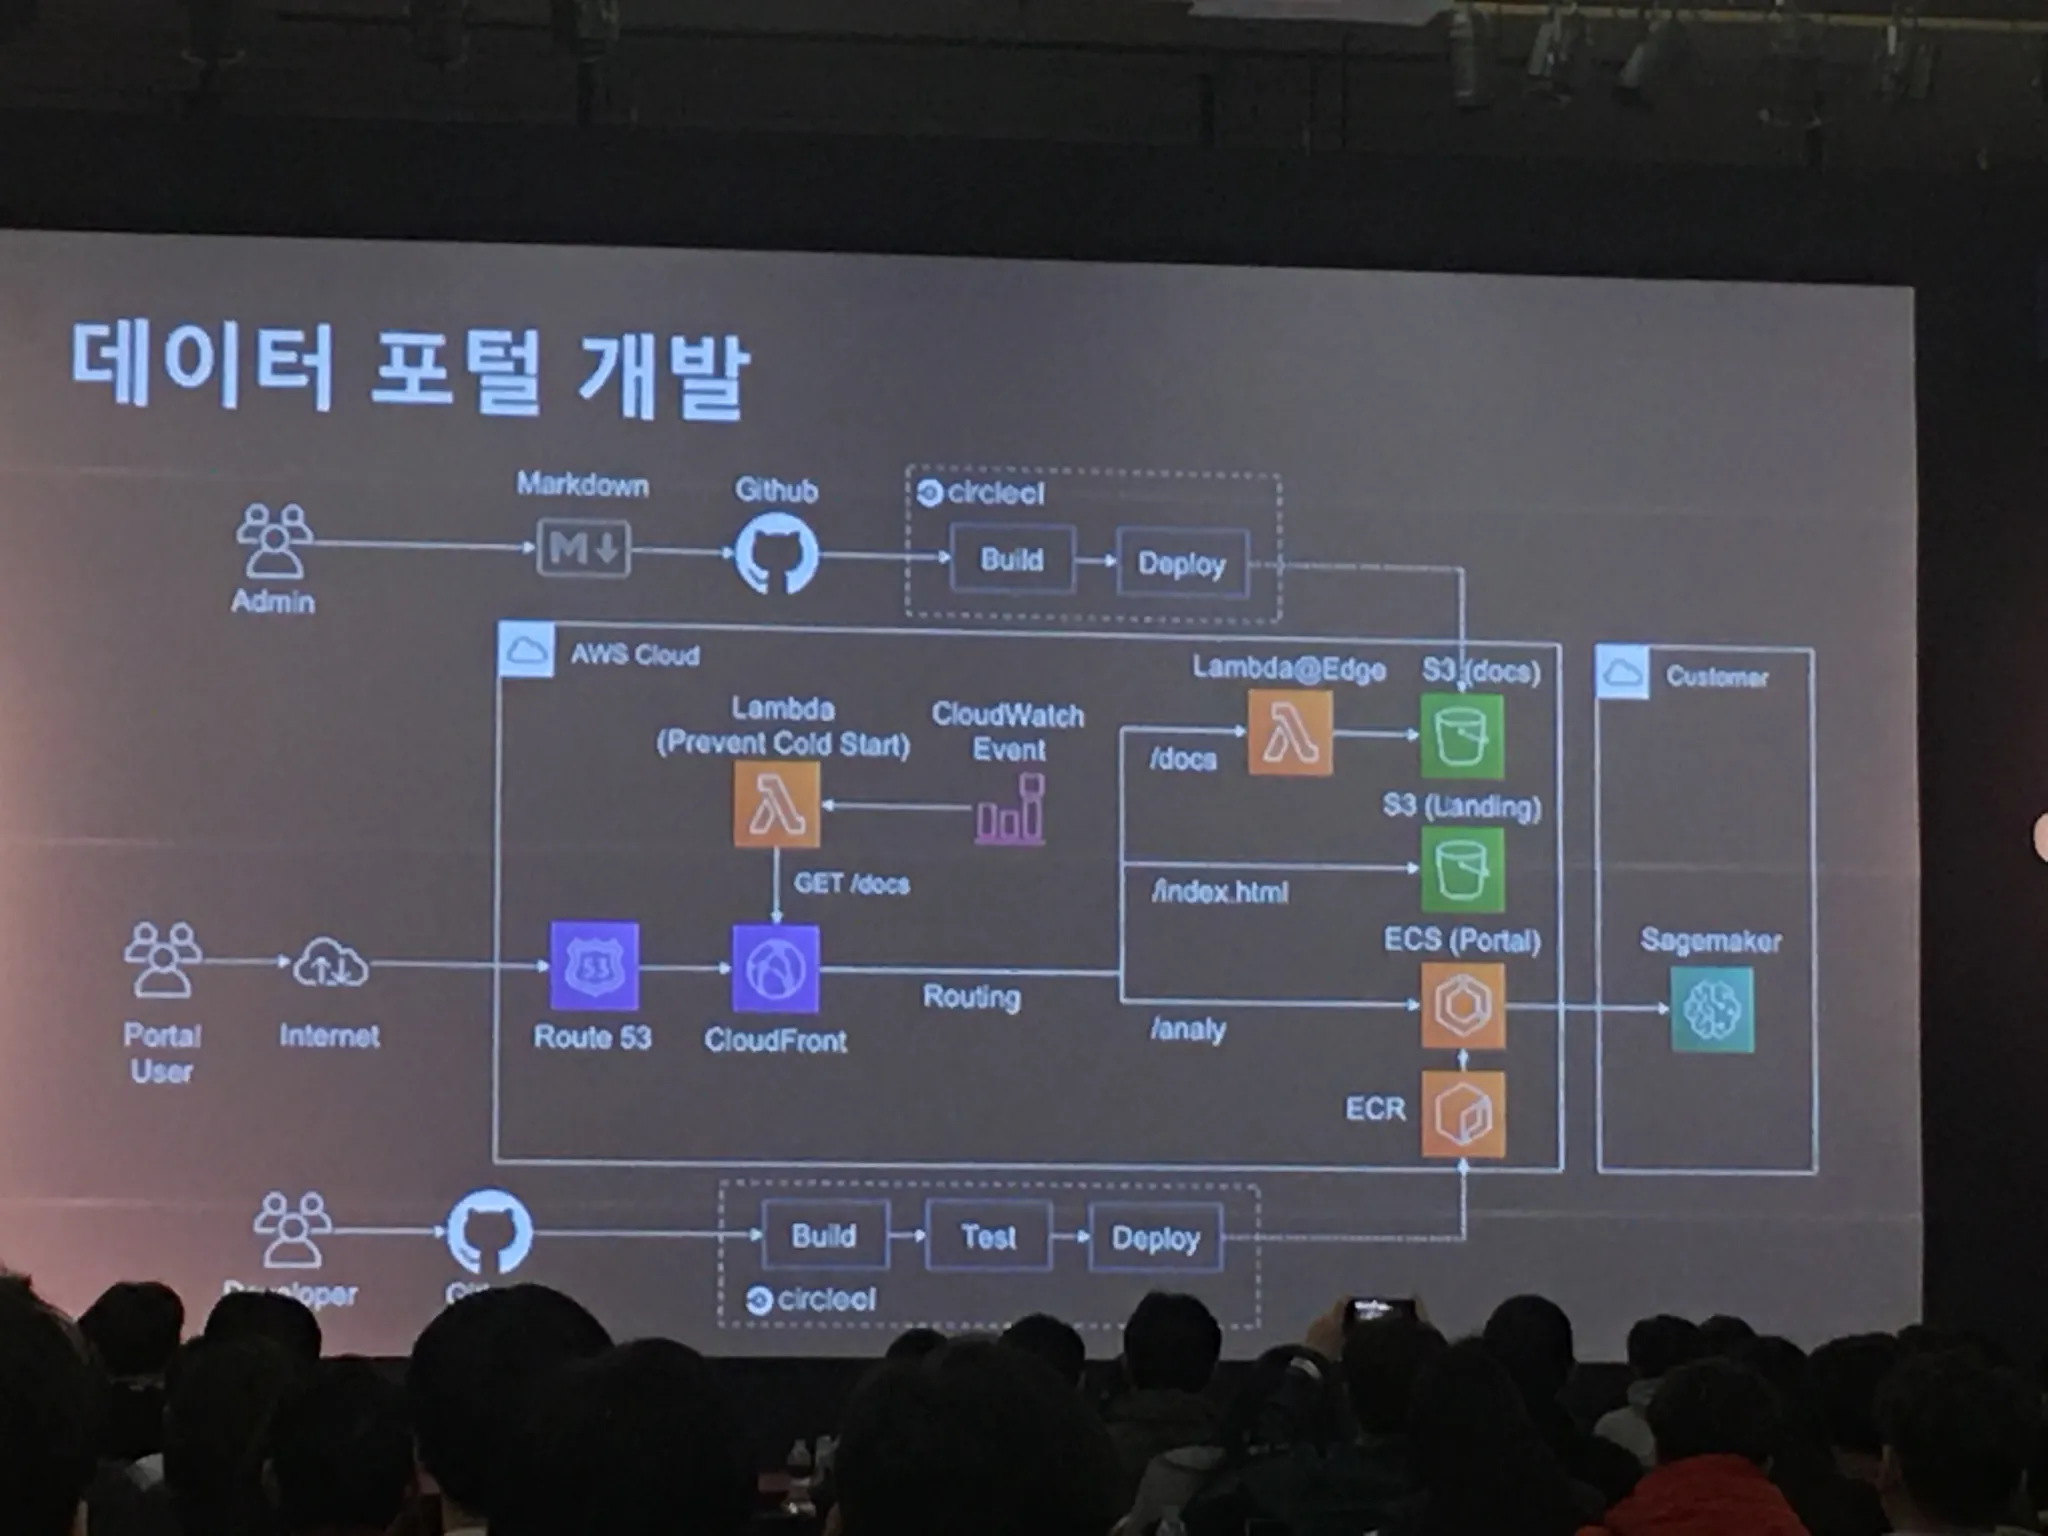
SI 회사에서의 데이터 레이크
-
Fully Managed Service 를 이용해서 단기적으로 서비스를 만들려고 했음
-
아키텍처
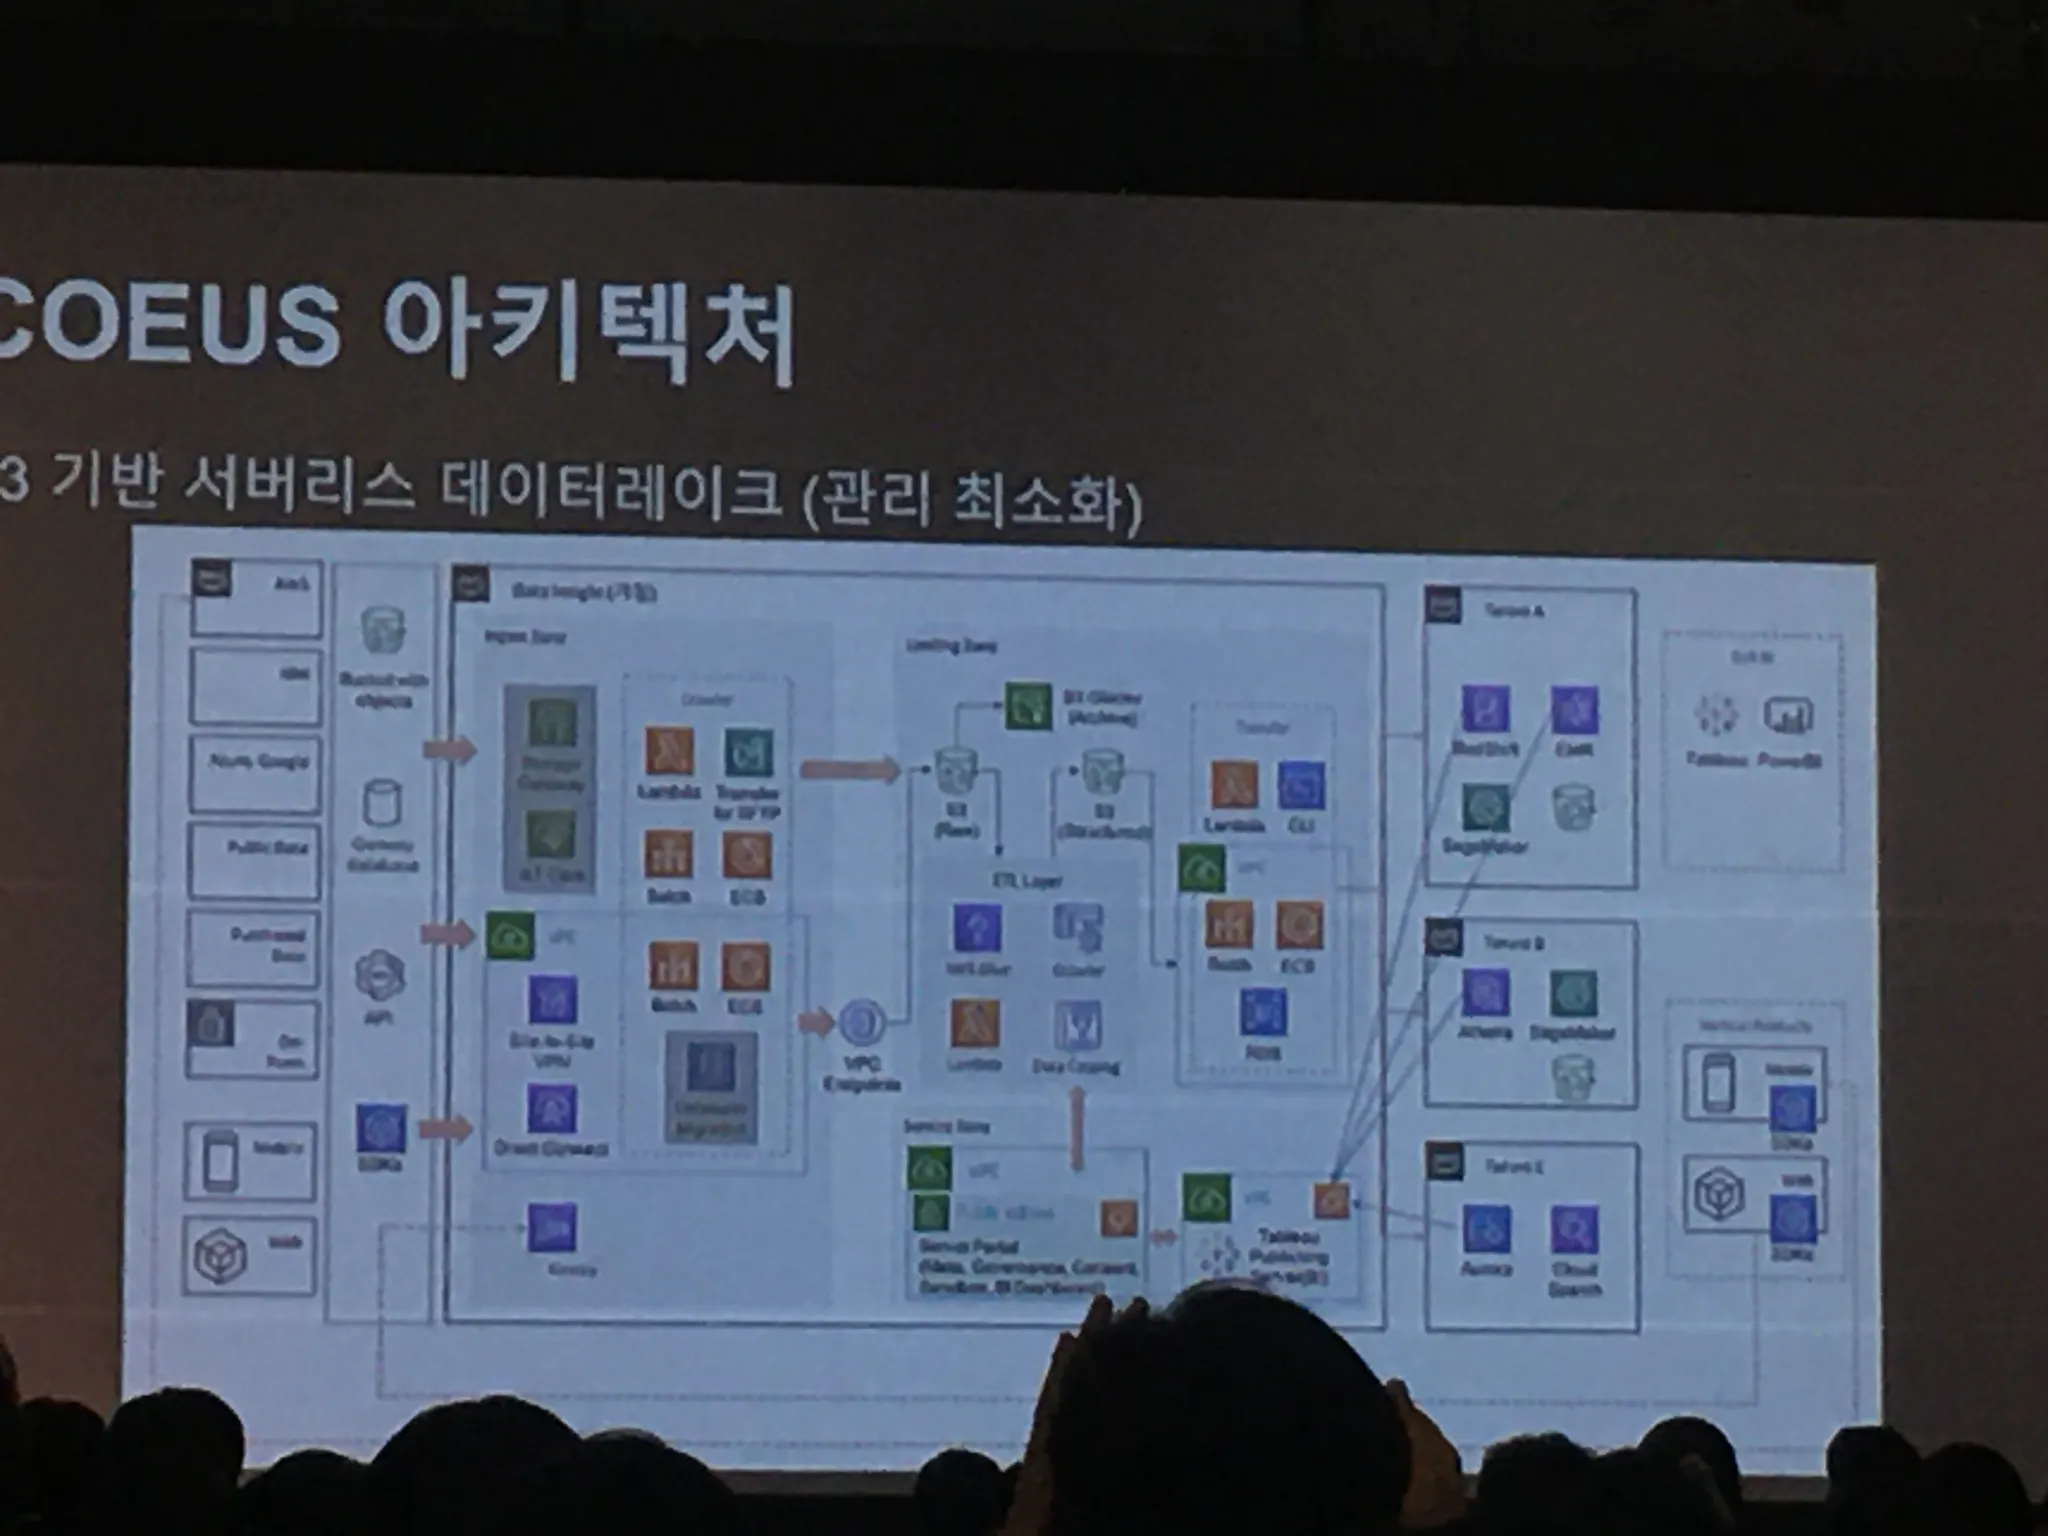
결론
- S3 기반의 서버리스 아키텍처도 충분히 적용 가능
- 완전 관리형 서비스만이 정답은 아님 ( Challenge )
- 기존 Hadoop ecosystem 통합
- 기존 조직과의 R&R ( 정보 보호, 개발, 인프라 등 )
- 서버리스 컴퓨팅 자원: EKS On Fargate 검토
AWS SAM으로 서버리스 아키텍처 운영하기 ( 이재면, Mymusictaste )
\
내용
AWS SAM 을 사용한 이유
- API Gateway, DynamoDB, SNS, SQS, Lambda 로 구성된 서비스 개발이 진행
- Infrastrcture as Code 를 통해서 배포를 구성
- 이미 ECS 로 구성된 Resources 들이 Terraform 으로 구성되어 있었음
sam local을 이용해서 로컬 환경에서 테스트 & 디버깅을 해볼 수 있음sam local start-apisam local start-api --docker-networksam local generate-event dynamodb update > event.jsonsam local invoke --event event.json SendMessagesam local lambda
SAM ( Serverless Application Model )
- Serverless 를 위한 Tool 로 편리하게 Abstraction 되어 있다.
- SAM Template
- Globals 로 공통적인 Config 설정
- Alias, Versioning 관리 가능
- Canary 배포 가능
- 다양한 Resource 들을 지원하고, CloudFormation Syntax 를 그대로 사용할 수 있다
--use-container옵션을 통해sam build를 하면 Amazon Linux Docker Image 를 이용해서 빌드
CloudFormation 기능 설명
- AWS SAM 은 AWS::Serverless 의 Resource 들이 cfn 이랑 호환될 수 있도록 변환한다
- cfn 에서 지원하는 기능들을 대부분 사용할 수 있다
Parameters
- Parameters 로 Input 을 Dynamic 하게 설정하여 Stack 을 생성 또는 업데이트 할 수 있다
- System Manager Parameter Store 에 저장한 값을 쉽게 연동하여 cfn parameter 값으로 사용할 수 있다
Mappings
- Key 값 별로 미리 Value 를 정의해놓고 사용할 수 있다
Conditions
- 조건을 만족하는 경우에만 Resource 를 생성할 수 있도록 설정할 수 있다
Nested Stacks
- 공통된 Resource 를 정의한 Template 을 재사용하여 만들 수 있다
StackSets
- StackSets 으로 여러 Region 과 여러 Acoount 에 Stack 을 생성하고 관리할 수 있음
- Organizations 에서 Service Mnaged Permission 으로 관리될 수 있을거라 생각
- Organization Unit ( OU ) 별로 Stack 을 자동 배포할 수 있게 될 예정
- OU 에 Account 가 추가되면 자동으로 Stack 이 배포되고, Account가 OU 에서 빠지면 자동으로 Stack 이 지워질 수 있음
아쉬웠던 점
- 이미 존재하는 Resource 들을 Stack 에 포함시키고 싶을 때
resource import2019년 11월에 발표됨- SAM Template 은 Transform 되어야 하는 것 때문에 다음과 같은 에러 발생
- SAM 은 Import 를 지원하는 Resource 들이 제한적임
Pipeline
Pipeline
- User → Template → Version Control → Test → Deploy ( Staging ) → Deploy ( Production )
구성에 도움이 되는 Tool
cfn-lint- CloudFormation Linter
- .cfnlintrc 이름의 YAML 파일에 다양한 옵션을 설정할 수 있음
change-set- cfn 에서 change sets 으로 Stack 에 어떤 부부닝 업데이트 될 지 적용하기 전에 알 수 있다
TaskCat- AWS QuickStart Team 에서 cfn template 을 테스트하기 위해 만들어진 tool
- 실제 Stack 을 만들고 결과 리포트를 생성